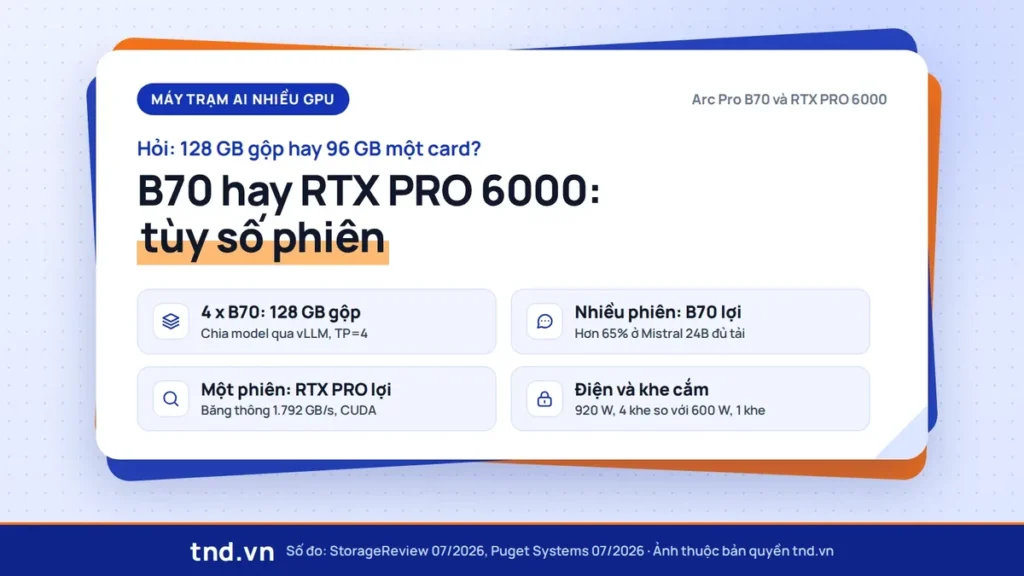
Cùng muốn chạy model lớn ngay tại văn phòng, có hai lối đi rất khác nhau. Lối thứ nhất là kiểu Project Battlematrix của Intel: gom bốn card 32 GB giá thấp vào một máy trạm. Lối thứ hai là dồn tiền cho một card 96 GB. Con số 128 lớn hơn 96, nhưng đó chưa phải toàn bộ câu chuyện. Bài này so hai cấu hình bằng số đo của bên thứ ba.
Ai nên đọc bài này
- Doanh nghiệp (góc A): đội IT muốn dựng một máy suy luận nội bộ cho cả nhóm dùng chung, chưa tới mức mua máy chủ 8 GPU.
- Người chạy AI tại chỗ (góc B): bạn đã chạm trần 32 GB VRAM và muốn lên model lớn hơn.
Nếu bạn mới chọn card đầu tiên, hãy đọc bài chọn Arc Pro B50, B60 hay B70 trước. Toàn cảnh các dòng nằm ở bài trụ về GPU Intel 2026.
Hai cấu hình trên giấy
| Tiêu chí | 4 x Arc Pro B70 | 1 x RTX PRO 6000 Blackwell |
|---|---|---|
| Bộ nhớ GPU | 4 x 32 GB GDDR6, gộp 128 GB | 96 GB GDDR7 trên một GPU |
| Băng thông bộ nhớ | 608 GB/s mỗi card | 1.792 GB/s |
| Điện phần GPU | 4 x 230 W, khoảng 920 W | 600 W |
| Khe cắm | 4 khe PCIe x16, mỗi card 2 slot | 1 khe PCIe x16, 2 slot |
| Phần mềm chính | Intel LLM Scaler (vLLM), llama.cpp Vulkan hoặc SYCL, PyTorch XPU | CUDA, TensorRT, gần như mọi công cụ AI |
| Giá tại Việt Nam | Giá tham khảo thị trường 59,9 đến 63 triệu mỗi card, tức khoảng 240 đến 252 triệu cho bốn card (18/11/2026) | 535.000.000 đ tại TND, đã bao gồm VAT (18/11/2026) |
Thông số B70 lấy từ Intel ARK (xem ngày 18/11/2026). Thông số RTX PRO 6000 lấy từ trang sản phẩm NVIDIA (xem ngày 18/11/2026). Tiền bốn card B70 chưa bằng một nửa một RTX PRO 6000, chưa tính bo mạch và nguồn lớn hơn.
Battlematrix là gì
Project Battlematrix là tên Intel đặt cho nền tảng máy trạm gồm CPU Xeon, từ hai đến tám card Arc Pro và bộ container LLM Scaler dựng trên vLLM. Với B70, cấu hình phổ biến là bốn card, gộp 128 GB.
- Người dùng gửi câu hỏiqua API tương thích OpenAI
- vLLM nhậncontainer LLM Scaler
- Chia model ra 4 cardtensor parallelism, TP=4
- Gộp nhiều phiênxử lý theo lô
- Trả tokencho từng người dùng
128 GB gộp không phải một khối bộ nhớ: LLM chia được qua vLLM hoặc llama.cpp. Model sinh ảnh trong ComfyUI thường chỉ nằm trên một card, nên trần thực tế vẫn là 32 GB mỗi workflow. Nếu việc chính của bạn là ảnh và video, hãy xem bài ComfyUI trên Arc Pro trước khi mua bốn card.
Số đo của bên thứ ba
StorageReview (14/07/2026). Trong bài đánh giá Arc Pro B70, ở Mistral Small 24B chạy vLLM, RTX PRO 6000 dẫn nhẹ tới mức 4 yêu cầu cùng lúc. Từ mức 8 trở lên B70 vượt lên, và ở mức 32 thì bốn B70 hơn một RTX PRO 6000 khoảng 65%, đạt 8.321 token/giây gộp. Ở Llama 3.1 8B, B70 đạt khoảng 85% thông lượng của RTX PRO 6000. Kết luận của họ: phần cứng đã sẵn sàng, phần mềm còn phải đuổi theo.
Puget Systems (giá cấu hình 07/2026). Bài đo bốn B70 trên máy Xeon, Ubuntu 25.04 cho thấy rõ hai mặt:
- Qwen3.6-27B bản đầy đủ FP16, không lượng tử hóa: 13,1 token/giây khi một người dùng, 95,9 token/giây gộp khi 8 người dùng.
- Bản 35B dạng MoE: 16,3 token/giây một người, 122 token/giây gộp ở 8 người.
- Llama 3.1 8B: 70,3 token/giây một người, 472 token/giây gộp ở 8 người.
- Tiền bốn card trong cấu hình của Puget khoảng 4.450 USD.
Puget cũng đã đính chính một kết quả trong bài vì lỗi tokenizer. Tôi chưa tìm thấy bài đo RTX PRO 6000 với đúng bộ model này, nên không đặt hai cột cạnh nhau.
Đọc gộp hai nguồn: bốn B70 mạnh khi nhiều người hỏi cùng lúc, yếu khi một người cần câu trả lời nhanh. Lý do nằm ở băng thông bộ nhớ, đã giải thích trong bài dung lượng và băng thông bộ nhớ GPU. Số đo một card với llama.cpp nằm ở bài B70 chạy local LLM.
Điện, khe cắm và tản nhiệt
Bốn khe PCIe x16
Bo mạch phổ thông không đủ khe và làn PCIe. Bạn cần nền tảng máy trạm như Xeon W hoặc Threadripper.
Khoảng 920 W cho GPU
Chưa tính CPU và ổ đĩa. Ước tính của người viết, chưa phải số đo: nên chọn nguồn từ 1.600 W.
Chọn cấu hình nào
Nghiêng về bốn Arc Pro B70 khi:
- Bạn phục vụ nhiều người cùng lúc bằng vLLM và đo hiệu quả theo tổng token.
- Bạn cần hơn 96 GB cho model lớp 100B trở lên, và chấp nhận tốc độ mỗi phiên vừa phải.
Nghiêng về một RTX PRO 6000 khi:
- Bạn cần tốc độ cho một phiên: lập trình cùng AI, chat trực tiếp, agent chạy tuần tự.
- Bạn dùng ComfyUI, fine-tune hoặc công cụ chỉ hỗ trợ CUDA.
- Bạn muốn một model lớn nằm trọn trên một GPU, không phải chia.
Tình trạng hàng tại TND (18/11/2026): Arc Pro B70 giá 58.990.000đ đã bao gồm VAT, hiện chưa có hàng sẵn, nhận đặt hàng. RTX PRO 6000 Blackwell 96 GB giá 535.000.000 đ, đã bao gồm VAT.
Còn phân vân giữa B70 và các card 32 GB khác, xem bài so B70 với Radeon AI PRO R9700 và RTX PRO 4500. Nếu bạn đang nghĩ tới việc chờ card máy chủ D270, bài chốt của loạt có bảng quyết định theo nhu cầu.
Câu hỏi thường gặp
4 card B70 có chạy được model 120B không?
Về dung lượng thì có: StorageReview (14/07/2026) nêu 128 GB đủ cho model MoE cỡ 120 tỷ tham số. Tốc độ phụ thuộc bản lượng tử hóa và số người dùng. Hãy chạy thử model của bạn trước khi chốt.
Bốn card có nhanh gấp bốn một card không?
Không. Theo Puget Systems (07/2026), model 8B chỉ nhanh khoảng gấp đôi khi một người dùng. Lợi ích chính của bốn card là chứa được model lớn và chịu được nhiều phiên.
Dùng Ollama trên 4 card B70 được không?
Các bài đo nêu trên dùng vLLM qua LLM Scaler và llama.cpp, chưa có số đo Ollama đáng tin cho cấu hình này. Nếu bạn mới làm quen, đọc Ollama là gì rồi thử trên một card trước.