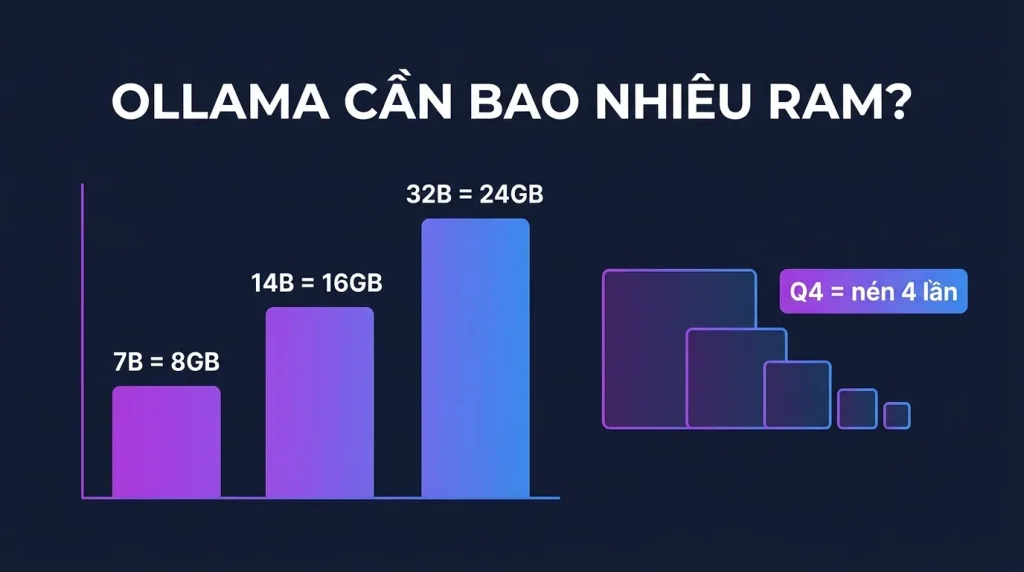
Trả lời nhanh: Ước lượng nhanh cho bản nén chuẩn Q4: RAM ≈ số tỷ tham số × 0.6-0.7GB, cộng 1-3GB cho ngữ cảnh. Cụ thể: 7B cần ~6GB, 14B cần ~11GB, 32B cần ~22GB. Quantization là kỹ thuật nén trọng số model, Q4_K_M là điểm cân mặc định của Ollama: nhẹ đi 4 lần so với bản gốc mà chất lượng gần như giữ nguyên với đa số việc.
Câu hỏi quyết định tiền bạc của mọi người chơi Ollama: mua/thuê máy bao nhiêu RAM là đủ? Trả lời được nó phải hiểu một khái niệm nghe học thuật nhưng thật ra rất đời: quantization, vì cùng một model 14B, bản nén khác nhau chênh nhau gấp ba lần RAM. Bài này giải thích quantization bằng ngôn ngữ thường, dạy đọc tag model trên kho Ollama, và cho công thức + bảng tra để chốt cấu hình không thừa không thiếu.
- Quantization = giảm độ chính xác từng trọng số để nén model: 16-bit → 4-bit là nhẹ đi ~4 lần
- Q4_K_M là chuẩn mặc định của Ollama, điểm cân đã được cộng đồng kiểm nghiệm
- Công thức: RAM ≈ tham_số(tỷ) × 0.6-0.7GB (Q4) + 1-3GB ngữ cảnh + phần cho hệ điều hành
- num_ctx to là RAM phình theo, làm RAG 16k ngữ cảnh phải cộng thêm hẳn một khoản
- Ổ NVMe không thay được RAM nhưng quyết định tốc độ nạp model và cứu cảnh đổi model liên tục
Quantization: nén model như nén ảnh
Model AI là hàng tỷ con số (trọng số), gốc lưu ở 16-bit mỗi số. Quantization lưu chúng bằng ít bit hơn, 8, 5, 4, thậm chí 2 bit, chấp nhận mất một chút độ chính xác đổi lấy dung lượng nhỏ đi tương ứng, hệt như JPEG nén ảnh: mắt thường khó thấy khác, file nhẹ đi nhiều lần. Điều bất ngờ dễ chịu: với LLM, nén xuống 4-bit kiểu khôn (giữ các phần nhạy cảm ở độ chính xác cao hơn, chữ K_M trong Q4_K_M nghĩa là vậy) làm chất lượng chỉ suy suyển rất nhỏ trong dùng thực tế. Dưới 4-bit (Q3, Q2) mới bắt đầu thấy model lú rõ rệt, vùng chỉ dành cho máy quá chật.
Đọc tag model trên kho Ollama
Tag dạng qwen2.5:14b-instruct-q4_K_M đọc từ trái sang: tên model, cỡ tham số (14 tỷ), biến thể (instruct: biết nghe lệnh), mức nén. Ba điều cần biết: tag ngắn (qwen2.5:14b) là bản Ollama chọn sẵn, thường chính là Q4_K_M, người dùng thường cứ tag ngắn mà dùng; xem trước dung lượng ngay trên trang model hoặc ollama list sau khi tải, con số đó xấp xỉ lượng RAM model chiếm khi nạp; q8/f16 dành cho ai dư RAM muốn vắt thêm chút chất lượng, mức tăng thường không xứng gấp đôi RAM, hãy nâng cỡ model thay vì nâng độ chính xác: 14B-Q4 hầu như luôn khôn hơn 7B-Q8 cùng mức RAM.
Công thức và bảng tra RAM
Công thức thực dụng cho Q4: RAM model ≈ số tỷ tham số × 0.6-0.7GB; cộng thêm ngữ cảnh (num_ctx 4k: ~0.5-1GB, 8k: ~1-2GB, 16k: ~2-4GB tùy model) và chừa hệ điều hành + dịch vụ khác ~1-2GB.
| Model (Q4) | RAM model | Tổng RAM máy nên có | Gói tham chiếu |
|---|---|---|---|
| 3-4B | ~2.5-3GB | 6GB | VPS phổ thông |
| 7-8B | ~4.5-5.5GB | 8GB | VPS 8GB |
| 14B | ~9-10GB | 16GB | VPS 16GB |
| 32B | ~19-21GB | 24-32GB | VPS 24GB+ |
| 70B | ~40-45GB | 64GB | Server riêng/GPU |
Chạy nhiều model cùng lúc (chat + embeddings cho RAG) thì cộng dồn từng con, cặp 14B + nomic-embed-text vừa xinh trong 16GB.
Vai của ổ đĩa: NVMe đáng tiền ở đâu
Nói thẳng để khỏi ảo tưởng: đĩa không thay được RAM, model tràn RAM phải swap là tốc độ rơi tự do, không ổ nào cứu nổi. Chỗ NVMe đáng tiền thật: nạp model, file 9GB từ ổ Enterprise U.2 vào RAM mất vài giây, ổ chậm mất cả phút, và cảnh này lặp mỗi lần đổi model, restart dịch vụ, hoặc keep_alive hết hạn; kho model, nghịch vài gia đình model là thư mục models chạm trăm GB, đọc ghi nhanh giúp pull/rm thoải mái. Server hay đổi model theo giờ (ban ngày chat 14B, ban đêm batch 32B) cảm nhận khác biệt NVMe rõ nhất.
Chốt cấu hình theo kịch bản thật
Thử nghiệm cá nhân: 8GB RAM chạy 7B thoải mái, đủ biết mình cần gì trước khi xuống tiền tiếp. Chatbot nội bộ đội nhỏ: 16GB + qwen2.5:14b thường trực (keep_alive dài), điểm cân được chọn nhiều nhất. RAG tài liệu công ty: 16GB tối thiểu vì num_ctx phải rộng, 24GB nếu muốn 14B + ngữ cảnh 16k êm ái, kiến trúc đầy đủ ở bài RAG. Chất lượng tối đa không GPU: 24-32GB + 32B, chậm nhưng khôn, hợp batch đêm hơn chat trực tiếp; tốc độ kỳ vọng xem bài VPS không GPU.
Bảng tra dung lượng theo mức nén
| Model | Q4 nén chuẩn | Q5 | Q8 | Bản gốc 16 bit |
|---|---|---|---|---|
| 7 tới 8 tỉ tham số | khoảng 4,5 tới 5 GB | khoảng 5,5 GB | khoảng 8 GB | khoảng 15 GB |
| 14 tỉ tham số | khoảng 9 GB | khoảng 10,5 GB | khoảng 15 GB | khoảng 28 GB |
| 32 tỉ tham số | khoảng 20 GB | khoảng 23 GB | khoảng 35 GB | khoảng 64 GB |
| 70 tỉ tham số | khoảng 42 GB | khoảng 48 GB | khoảng 75 GB | khoảng 140 GB |
Cộng thêm cho ngữ cảnh: mức mặc định tốn khoảng 0,5 tới 1 GB, ngữ cảnh 16 nghìn từ tốn thêm 2 tới 4 GB, ngữ cảnh 32 nghìn từ tốn 4 tới 8 GB. Đây là khoản hay bị quên khi làm hệ thống hỏi đáp trên tài liệu, và triệu chứng là máy chạy được lúc thử nhưng hết bộ nhớ khi đưa tài liệu thật vào.
Cộng tiếp phần cho hệ điều hành và các phần mềm khác, thường 2 tới 4 GB. Máy 16 GB chạy model 14 tỉ tham số ở mức nén chuẩn với ngữ cảnh vừa là vừa khít, không còn nhiều chỗ thở.
Đọc tên bản nén trên kho model
| Ký hiệu | Nghĩa | Nên dùng khi |
|---|---|---|
Q4_K_M | Nén 4 bit, chất lượng trung bình theo cách chia khối | Mặc định. Cân bằng tốt nhất cho gần như mọi việc |
Q4_K_S | Nén 4 bit, bản nhỏ hơn | Máy chật bộ nhớ, chấp nhận chất lượng thấp hơn chút |
Q5_K_M | Nén 5 bit | Còn dư bộ nhớ, muốn thêm một chút chất lượng |
Q8_0 | Nén 8 bit | Gần như không mất chất lượng, nhưng tốn gấp đôi Q4 |
fp16 | Bản gốc | Chỉ khi có card đồ họa lớn và cần chất lượng tối đa |
Kinh nghiệm thực dụng: chênh lệch chất lượng giữa mức 4 bit và 8 bit nhỏ hơn nhiều so với chênh lệch giữa model 7 tỉ và 14 tỉ tham số. Nếu phải chọn, ưu tiên model lớn hơn ở mức nén 4 bit thay vì model nhỏ hơn ở mức nén cao.
Kiểm bộ nhớ thật khi model đang chạy
ollama ps                 # cot SIZE cho biet dang chiem bao nhieu, va chay o dau
free -h                   # bo nho con lai va vung nho tam
vmstat 2                  # cot si va so khac 0 lien tuc la dang trao trang, rat cham
nvidia-smi                # neu co card NVIDIA, xem VRAM da dung
Trong kết quả ollama ps, cột cho biết chạy trên vi xử lý hay trên card. Thấy chia phần trăm giữa hai bên nghĩa là model không vừa card nên phải dùng cả bộ nhớ hệ thống, và tốc độ tụt hẳn. Khi đó chọn mức nén nhỏ hơn để model vừa hẳn vào card sẽ nhanh hơn nhiều.
Vai của ổ đĩa: đáng tiền ở đâu
- Nạp model lần đầu. Model 20 GB nạp từ ổ chậm mất cả phút, từ ổ NVMe mất khoảng mười giây. Với máy dùng chung nhiều model đổi qua đổi lại, khác biệt này cảm nhận rõ mỗi ngày.
- Ổ nhanh không thay được bộ nhớ. Model không vừa bộ nhớ thì hệ thống phải tráo trang liên tục, và lúc đó tốc độ tụt hàng chục lần dù ổ nhanh tới đâu. Thứ tự ưu tiên: đủ bộ nhớ trước, rồi mới tới ổ.
- Dung lượng lưu trữ. Vài model là vài chục gigabyte. Kiểm bằng
du -sh ~/.ollama/modelsvà dọn định kỳ.
Câu hỏi thường gặp
Máy 8GB RAM có chạy được model 14B không?
Bản Q4 của 14B cần ~9-10GB, không vừa 8GB một cách tử tế: hoặc swap (chậm khủng khiếp) hoặc dùng bản nén sâu Q3 (chất lượng tụt rõ). Đường đúng: chạy 7B, hoặc thêm RAM.
GPU có thay đổi bài toán RAM không?
Có, model nạp vào VRAM của GPU thay vì RAM, và tốc độ nhanh hơn hàng chục lần. Nhưng bảng tính dung lượng giữ nguyên logic: VRAM 12GB chạy 14B-Q4 vừa khít. Không GPU thì RAM + CPU nhiều nhân vẫn dùng được thật với 7-14B.
Vì sao model chiếm RAM nhiều hơn dung lượng file?
Ngoài trọng số còn bộ nhớ ngữ cảnh (KV cache) phình theo num_ctx và phần phụ trợ của runtime. Đó là lý do công thức luôn cộng 1-3GB thay vì lấy đúng cỡ file.
Swap trên NVMe có cứu được khi thiếu RAM chút ít không?
Thiếu vài trăm MB thì swap NVMe giúp sống sót qua đỉnh điểm; thiếu vài GB thì không, tốc độ sinh chữ rơi xuống mức không dùng nổi. Swap là dây an toàn chống crash, không phải RAM mở rộng cho LLM.