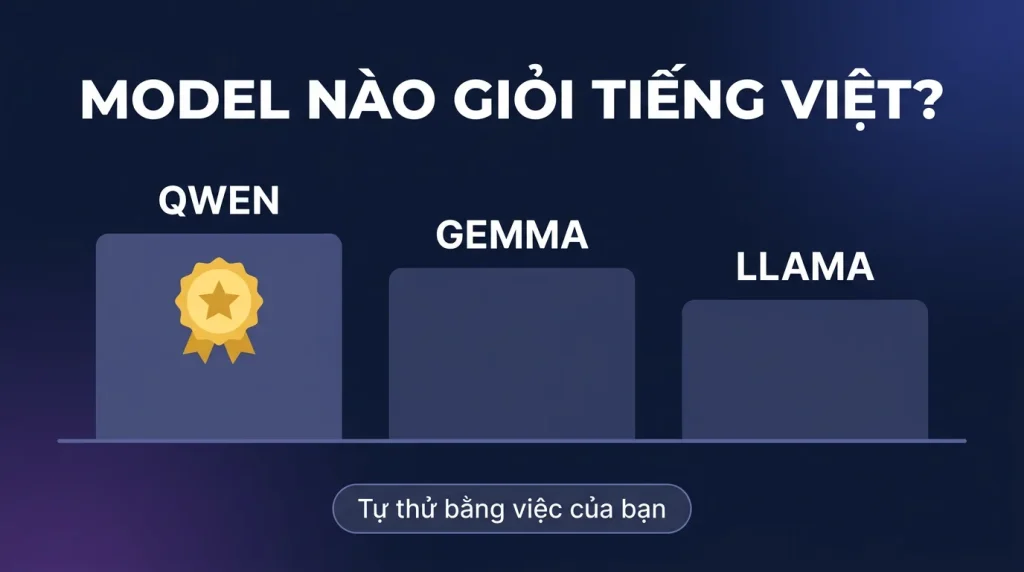
Trả lời nhanh: Mặt bằng 2026: Qwen 2.5 là lựa chọn an toàn nhất cho tiếng Việt ở mọi cỡ (7B cho máy thường, 14B điểm cân, 32B khi cần chất lượng); Gemma đời mới bám sát ở cỡ nhỏ-vừa và văn phong mượt; Llama mạnh tiếng Anh và hệ sinh thái nhưng tiếng Việt kém tự nhiên hơn; DeepSeek-R1 (bản distill) đáng thử khi cần suy luận từng bước. Đừng tin bảng xếp hạng, thử bằng chính việc của bạn với bộ lệnh trong bài.
Câu hỏi đầu tiên của mọi người Việt cài Ollama: model nào nói tiếng Việt tử tế? Câu trả lời thay đổi theo từng đợt model mới, nhưng cách chọn thì bền: hiểu gia đình model nào mạnh gì, khớp cỡ model với RAM đang có, và quan trọng nhất, tự thử trên đúng loại việc của mình thay vì tin benchmark tiếng Anh. Bài này cho cả ba: bản đồ model, bảng khớp RAM, và quy trình thử 15 phút.
- Qwen 2.5 (Alibaba): tiếng Việt ổn định nhất ở mọi cỡ, mặc định nên bắt đầu từ đây
- Gemma (Google): văn phong mượt, cỡ nhỏ chạy nhanh, đối trọng đáng thử ở 4-12B
- Llama (Meta): hệ sinh thái lớn nhất nhưng tiếng Việt thường phải 70B mới đã, quá cỡ đa số máy
- DeepSeek-R1 distill: suy luận từng bước cho toán/logic, chậm hơn, dài dòng hơn
- Quy tắc vàng: benchmark của bạn là 10 câu hỏi thật của chính bạn
Bản đồ các gia đình model trên Ollama
Qwen 2.5, huấn luyện đa ngữ nghiêm túc trong đó có tiếng Việt, đủ cỡ từ 0.5B đến 72B, thêm nhánh coder cho lập trình. Kinh nghiệm cộng đồng Việt khá đồng thuận: cùng cỡ, Qwen trả lời tiếng Việt tự nhiên và ít lạc đề hơn phần còn lại. Gemma, chưng cất từ công nghệ Gemini, mạnh bất ngờ ở cỡ nhỏ, tiếng Việt tốt dần theo đời. Llama, chuẩn mực cộng đồng, tài liệu và fine-tune nhiều nhất; tiếng Việt dùng được nhưng hay pha văn dịch ở cỡ 8B. Phi (Microsoft), nhỏ mà thông minh ở suy luận tiếng Anh, tiếng Việt không phải sở trường. DeepSeek-R1 distill, mang phong cách suy nghĩ thành tiếng, hợp toán và phân tích, đổi lại chậm và dài dòng. Ngoài ra có các bản fine-tune tiếng Việt của cộng đồng trên Hugging Face, chất lượng dao động, thử kỹ trước khi dựa vào.
Khớp model với RAM đang có
| RAM khả dụng | Cỡ model | Gợi ý cụ thể | Dùng cho |
|---|---|---|---|
| ~6GB | 3-4B | qwen2.5:3b · gemma nhỏ | Phân loại, trích xuất, việc đơn giản |
| ~8GB | 7-8B | qwen2.5:7b · llama3.1:8b | Chatbot, tóm tắt, dịch thường ngày |
| ~12-16GB | 14B | qwen2.5:14b · gemma tầm 12B | Điểm cân chất lượng/chi phí cho đa số đội |
| ~24GB | 32B | qwen2.5:32b · deepseek-r1:32b | Nội dung dài, suy luận, độ chính xác cao |
Số RAM trên là cho bản nén chuẩn (Q4) kèm chỗ thở cho ngữ cảnh, công thức tính chi tiết nằm ở bài RAM & quantization. Chạy CPU thuần thì 7-14B là vùng thực dụng; tốc độ thực tế từng đo trong bài VPS không GPU.
Chọn theo loại việc, không theo điểm số
Chatbot CSKH / hỏi đáp nội bộ: qwen2.5:7b khởi điểm, lên 14B khi câu trả lời cần dài và chuẩn giọng, nhớ system prompt tiếng Việt tử tế quyết định 50% chất lượng. Tóm tắt, viết lại văn bản: 14B trở lên mới giữ được ý và mượt; gemma cỡ vừa cũng đáng thử. Dịch: qwen nổi trội cặp Việt-Anh-Trung. Code: nhánh qwen2.5-coder đúng nghề; hỏi đáp code tiếng Việt vẫn ổn. Suy luận toán/logic: deepseek-r1 distill, chấp nhận chậm. Trích xuất dữ liệu có cấu trúc (JSON từ email, hóa đơn): model nhỏ 3-7B + temperature thấp + prompt chặt là đủ, đừng phí model to.
Quy trình thử 15 phút: benchmark của chính bạn
# keo 2-3 ung vien cung luc
ollama pull qwen2.5:7b && ollama pull gemma3 && ollama pull llama3.1:8b
# chay tung model voi CUNG mot bo cau hoi that cua ban
ollama run qwen2.5:7b
# vi du bo thu: 1 email khach can tra loi, 1 doan van can tom tat,
# 1 cau hoi nghiep vu, 1 yeu cau viet content, 1 doan can dich
Chấm bằng mắt theo ba tiêu chí: đúng ý không bịa, văn có tự nhiên như người Việt viết, có tuân system prompt. Kéo thêm --verbose khi run để thấy tốc độ token/s, chất lượng ngang nhau thì chọn con nhanh hơn. Chốt xong, đóng model + system prompt thành Modelfile theo bài lệnh A-Z để cả đội dùng một chuẩn.
Giữ đầu lạnh giữa mùa model mới
Vài tháng lại có model mới phá đảo bảng xếp hạng, phần lớn đo bằng benchmark tiếng Anh, và cải thiện tiếng Việt không phải lúc nào cũng đi kèm. Chiến lược bền cho người dùng thật: giữ một bộ câu thử cố định của riêng bạn, model mới ra thì pull về chạy đúng bộ đó 15 phút, hơn thật mới đổi, và nhờ Modelfile, đổi model nền chỉ là sửa một dòng FROM, app phía trên không biết gì. Đừng đập stack chạy ổn chỉ vì một dòng tít.
Bộ lệnh thử model bằng chính việc của bạn
ollama pull qwen2.5:7b ollama pull gemma2:9b ollama pull llama3.1:8b # Chay cung mot cau hoi qua ba model, so ket qua for m in qwen2.5:7b gemma2:9b llama3.1:8b; do echo "=== $m" echo "Tom tat doan van sau thanh 3 gach dau dong:" | ollama run $m done ollama ps # xem model nao dang nap, chay tren CPU hay GPU ollama list # dung luong tung model da tai
Mười câu hỏi thật của chính công việc bạn đáng giá hơn mọi bảng xếp hạng. Gợi ý bộ thử cho doanh nghiệp Việt Nam: tóm tắt một email khách hàng, viết lại một đoạn cho lịch sự hơn, phân loại một đoạn thành nhóm, trích thông tin ra dạng có cấu trúc, và trả lời một câu hỏi nghiệp vụ có số liệu.
Bảng khớp cỡ model với bộ nhớ máy
| Cỡ model | Dung lượng ở mức nén 4 bit | Máy tối thiểu | Tốc độ cảm nhận trên CPU |
|---|---|---|---|
| 3 tới 4 tỉ tham số | khoảng 2 tới 3 GB | 8 GB RAM | Nhanh, hợp cho phân loại và trích thông tin |
| 7 tới 9 tỉ tham số | khoảng 5 tới 6 GB | 16 GB RAM | Chấp nhận được, đây là mức cân bằng phổ biến nhất |
| 14 tỉ tham số | khoảng 9 tới 10 GB | 24 GB RAM hoặc card 12 GB | Chậm trên CPU, cần card đồ họa để dùng thoải mái |
| 32 tỉ tham số | khoảng 20 GB | Card 24 GB | Chỉ nên chạy trên máy có card đồ họa |
Nhớ cộng thêm phần bộ nhớ cho cửa sổ ngữ cảnh. Xử lý tài liệu dài cần nhiều hơn con số trong bảng, và đây là chỗ hay bị thiếu khi làm hệ thống hỏi đáp tài liệu.
Chọn theo loại việc
| Việc | Ưu tiên gì | Gợi ý |
|---|---|---|
| Tóm tắt và viết lại tiếng Việt | Độ tự nhiên của câu chữ | Model đa ngữ được huấn luyện có tiếng Việt, cỡ 7B trở lên |
| Phân loại, gắn nhãn, trích thông tin | Tốc độ và khả năng bám định dạng | Model nhỏ 3 tới 4B là đủ, kèm tham số ép trả về dạng JSON |
| Hỗ trợ lập trình | Huấn luyện chuyên cho mã nguồn | Nhánh dành cho lập trình của các gia đình model lớn |
| Suy luận nhiều bước, toán và logic | Khả năng suy luận | Các model có chế độ suy luận từng bước, đổi lại chậm và dài dòng hơn |
| Hỏi đáp trên tài liệu nội bộ | Cửa sổ ngữ cảnh dài và model nhúng tốt | Kết hợp một model sinh văn bản với một model nhúng riêng |
Ba điều giữ đầu lạnh giữa mùa model mới
- Model mới nhất không tự động tốt nhất cho việc của bạn. Bảng xếp hạng đo bằng bài thi tiếng Anh, không đo việc bạn làm bằng tiếng Việt.
- Cỡ model quan trọng hơn tên model. Nhảy từ 7B lên 14B thường cải thiện rõ hơn là đổi từ gia đình này sang gia đình khác cùng cỡ.
- Giữ bộ thử của riêng bạn. Mười câu hỏi cố định lưu trong một tệp, model mới ra thì chạy lại đúng bộ đó. Sau vài lần bạn có cơ sở so sánh thật thay vì cảm giác.
Câu hỏi thường gặp
Model nào tiếng Việt tốt nhất tuyệt đối?
Không có câu trả lời tuyệt đối, phụ thuộc cỡ máy và loại việc. Mặt bằng 2026 thì Qwen 2.5 là khởi điểm an toàn nhất; nhưng 15 phút tự thử trên việc của bạn đáng giá hơn mọi bảng xếp hạng, kể cả khuyến nghị trong bài này.
Có nên dùng model fine-tune tiếng Việt của cộng đồng?
Đáng thử khi việc của bạn rất đặc thù văn phong Việt (viết content, văn bản hành chính). Lưu ý chất lượng dao động mạnh, ít được cập nhật, và kiểm kỹ giấy phép trước khi dùng thương mại.
7B và 14B khác nhau nhiều không, có đáng nâng RAM?
Khác rõ ở độ mạch lạc câu dài, giữ ngữ cảnh và ít bịa, tiếng Việt hưởng lợi nhiều vì là ngôn ngữ ít tài nguyên hơn tiếng Anh. Nếu output đưa thẳng cho khách đọc, 14B đáng từng đồng RAM.
Model bản instruct và bản thường khác gì?
Tag mặc định trên Ollama đã là bản instruct (biết nghe lệnh, chat được). Bản base/text chỉ dành cho người tự fine-tune, người dùng thường không cần quan tâm.