
Arc Pro B70 có 32 GB VRAM ở mức giá thấp hơn nhiều card 32 GB khác, nên dân chạy local LLM hỏi rất nhiều: tốc độ thật là bao nhiêu? Câu trả lời thay đổi theo ba thứ: loại model, backend và phiên bản driver. Bài này gom số đo đã công bố của nguồn ngoài vào một bảng và gợi ý backend theo từng việc.
Cách đọc số trong bài
Mỗi nguồn đo trên một máy, một bản driver, một cách đặt tham số. Vì vậy không nên lấy số của nguồn này trừ số của nguồn kia. Hãy đọc theo từng dòng: model gì, backend gì, mấy phiên cùng lúc, đo ngày nào.
Ba khái niệm cần nắm: tốc độ sinh (token/giây khi model viết câu trả lời), tốc độ đọc prompt hay prefill (token/giây khi model đọc đầu vào), và thông lượng gộp (tổng token/giây của nhiều phiên chạy song song). Một card có thể đọc prompt rất nhanh nhưng sinh chữ chậm.
Bảng số đo Arc Pro B70, có nguồn và ngày
| Cấu hình đo | Kết quả | Nguồn, ngày |
|---|---|---|
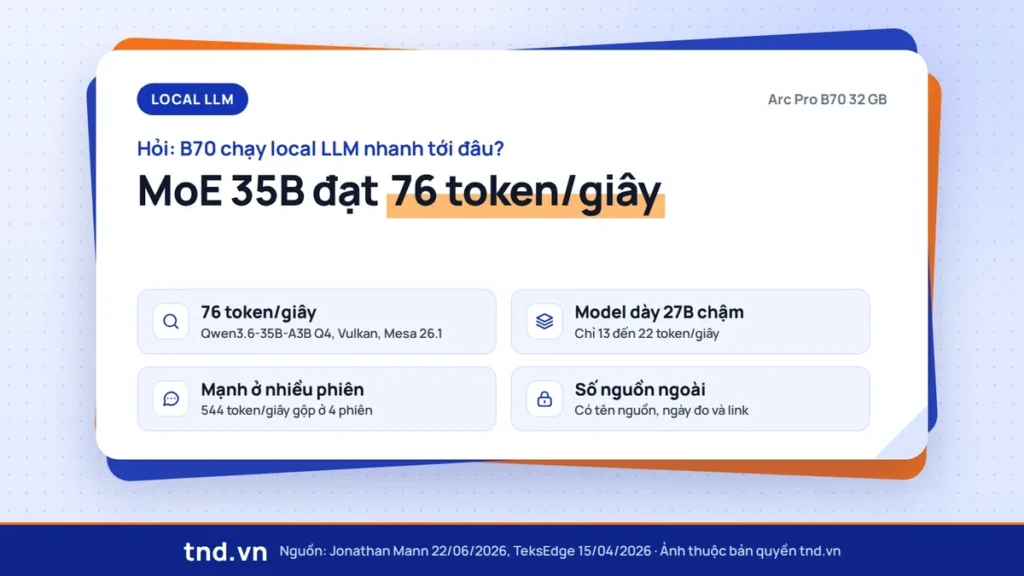
| 1 card, llama.cpp Vulkan, Mesa 26.1, Qwen3.6-35B-A3B Q4_K_M | 76 token/giây sinh 1 luồng; khoảng 1.800 token/giây đọc prompt; 544 token/giây gộp ở 4 phiên | Jonathan Mann, 22/06/2026 |
| 1 card, Vulkan, Qwen3.6-27B Q4_K_XL (model dày) | 20 token/giây | Jonathan Mann, 22/06/2026 |
| 1 card, Qwen3.5-27B Q4, 1 người dùng | vLLM 13,43; LM Studio Vulkan 11,87; llama.cpp SYCL tinh chỉnh 22,47 token/giây | TeksEdge trên X, 15/04/2026 |
| 1 card, Vulkan, KV cache q4_0, prompt dài dần | 73,1 token/giây ở prompt 2.048 token, còn 37,1 ở prompt 32.768 token | Jonathan Mann, 31/07/2026 |
| 1 card, model 27B Q8_0, Vulkan theo bản Mesa | 6,1 token/giây trên Mesa 26.0.8; 17,9 trên Mesa 26.1.7. SYCL đọc prompt nhanh hơn Vulkan 2,2 lần | Thảo luận 27593 của llama.cpp, 25/08/2026 |
| 4 card, vLLM (Intel LLM Scaler), Mistral Small 24B | 450 token/giây ở batch 1; 8.321 ở batch 32, hơn 1 RTX PRO 6000 khoảng 65%. RTX PRO 6000 nhỉnh hơn cho tới batch 4 | StorageReview, 14/07/2026 |
| 4 card, vLLM, FP16 không lượng tử | Qwen3.6-27B: 13,1 token/giây 1 người, 95,9 ở 8 người. Bản 35B MoE: 16,3 và 122 | Puget Systems, 18/06/2026 |
Ba điều rút ra từ bảng
Một, loại model quyết định tốc độ hơn cả tên card. B70 có băng thông bộ nhớ 608 GB/s. Jonathan Mann giải thích: model MoE 35B-A3B chỉ kích hoạt khoảng 3 tỷ tham số cho mỗi token, nên mỗi bước sinh đọc ít dữ liệu hơn hẳn model dày 27B. Kết quả là 76 so với 20 token/giây trên cùng một máy. Lý do gốc nằm ở bài dung lượng và băng thông bộ nhớ GPU.
Hai, driver có thể đổi kết quả gấp đôi. Cùng card, cùng model, Mesa 26.1 đưa 42,5 token/giây (Jonathan Mann, 21/05/2026) lên khoảng 76. Số cũ trên mạng trong khoảng 38 đến 55 token/giây là số trước Mesa 26.1. Khi đọc một bài đo, hãy tìm ngày đo và bản driver trước.
Ba, B70 mạnh ở nhiều phiên, yếu ở chat đơn với model dày. TeksEdge nhận xét card đọc prompt tốt nhưng sinh token ở chat một người vẫn chậm hơn RTX 5070 Ti. Ngược lại, 4 phiên song song đạt 544 token/giây gộp. Khi ngữ cảnh dài tới 32.768 token, tốc độ sinh giảm còn một nửa với thiết lập Vulkan và KV cache q4_0; Mann cho biết cách khắc phục nằm ở thiết lập KV cache, chi tiết trong bài gốc.
Chọn backend nào
| Nhu cầu | Backend nên thử trước | Lưu ý |
|---|---|---|
| Một người, model GGUF, muốn chạy được nhanh | llama.cpp Vulkan | Cần Mesa 26.1 trở lên. Tốc độ phụ thuộc mạnh vào bản driver |
| Prompt dài, agent đọc nhiều tài liệu | llama.cpp SYCL | Build với -DGGML_SYCL_F16=ON: đọc prompt nhanh hơn 3,72 lần, mặc định đang tắt (thảo luận 27593, 25/08/2026). Cần cài oneAPI |
| Nhiều người dùng, nhiều card | vLLM qua container Intel LLM Scaler | Danh sách model hỗ trợ còn hẹp. vLLM XPU hiện phục vụ model ở FP16 (ASUS, 19/10/2026) |
Ví dụ dưới đây dựng theo cấu hình Jonathan Mann mô tả ngày 22/06/2026: 4 phiên, mỗi phiên 64K ngữ cảnh. TND chưa chạy lại lệnh này trên phần cứng của mình.
llama-server -m Qwen3.6-35B-A3B-UD-Q4_K_M.gguf \ -ngl 99 --ubatch-size 2048 \ --parallel 4 -c 262144Phần mềm vẫn là điểm yếu: StorageReview kết luận ngày 14/07/2026 rằng phần cứng đã sẵn sàng còn phần mềm phải đuổi theo. Một model mới ra có thể chưa chạy trên vLLM của Intel trong nhiều tuần, như trường hợp Qwen3.6 mà Jonathan Mann ghi lại ngày 21/05/2026. Nếu bạn cần mọi thứ chạy ngay, card NVIDIA với CUDA vẫn ít việc phải chỉnh hơn.
Ai nên quan tâm
- Người chạy local LLM tại nhà hoặc văn phòng nhỏ: B70 hợp khi bạn cần 32 GB cho model MoE lớn, ngữ cảnh dài hoặc vài agent chạy song song, và chấp nhận tự chỉnh driver trên Linux.
- Doanh nghiệp dựng máy suy luận nội bộ: số 4 card của StorageReview và Puget cho thấy hướng nhiều card giá thấp phục vụ nhiều người cùng lúc. Bài 4 x Arc Pro B70 128 GB hay 1 x RTX PRO 6000 96 GB phân tích kỹ phương án này.
- Người còn phân vân giữa các hãng: xem B70 so với Radeon AI PRO R9700 và RTX PRO 4500, hoặc chọn B50, B60 hay B70. Bức tranh chung nằm ở toàn cảnh GPU Intel 2026.
Về giá: B70 trên thị trường Việt Nam đang ở khoảng 59,9 đến 63 triệu đồng (giá tham khảo thị trường, 18/11/2026). Tại TND, Arc Pro B70 32 GB có giá 58.990.000đ đã bao gồm VAT, hiện chưa có hàng sẵn, nhận đặt hàng.
Câu hỏi thường gặp
Arc Pro B70 chạy được model lớn cỡ nào trên một card?
Theo Jonathan Mann (21/05/2026), một card chạy Qwen3.6-35B-A3B Q4 với cửa sổ ngữ cảnh 262K token khi lượng tử KV cache 4 bit. Model dày 27B Q4 cũng vừa, nhưng tốc độ sinh chỉ quanh 13 đến 22 token/giây theo các nguồn trong bảng.
Nên dùng Vulkan hay SYCL?
Vulkan dễ cài và sinh token nhanh với model MoE trên Mesa 26.1. SYCL đọc prompt nhanh hơn rõ khi build đúng cờ F16, hợp với prompt dài. Hai nguồn đo cho kết quả khác nhau theo model, nên hãy thử cả hai với đúng model bạn dùng.
B70 có nhanh hơn RTX PRO 6000 không?
Một card thì không. Số 65% của StorageReview là 4 card B70 so với 1 card RTX PRO 6000 ở batch 32, tức so theo số tiền bỏ ra chứ không theo số card. Ở tải nhẹ tới batch 4, RTX PRO 6000 vẫn nhỉnh hơn.