Trả lời nhanh: OpenRouter tính tiền theo token vào + token ra với đơn giá riêng từng model, chênh nhau hàng trăm lần giữa model đỉnh và model mở. Model tag :free dùng không mất tiền nhưng giới hạn lượt/ngày, chỉ hợp thử nghiệm. Tiết kiệm thật đến từ ba nguồn: chọn model đúng cỡ việc, viết prompt gọn + chặn độ dài trả lời, và đẩy việc khối lượng lớn về model rẻ hoặc Ollama tự host.
Hóa đơn AI phình không phải vì giá token đắt lên, mà vì không ai nhìn nó cho đến khi giật mình. OpenRouter vô tình là công cụ dạy tiết kiệm tốt nhất: mọi chi tiêu mọi model nằm trên một dashboard, chênh lệch giá phơi ra trần trụi. Bài này dạy đọc bảng giá cho đúng, nói thật về giới hạn của model free, và 5 mẹo đã giúp các đội Việt cắt 50-90% hóa đơn mà chất lượng người dùng không đổi.
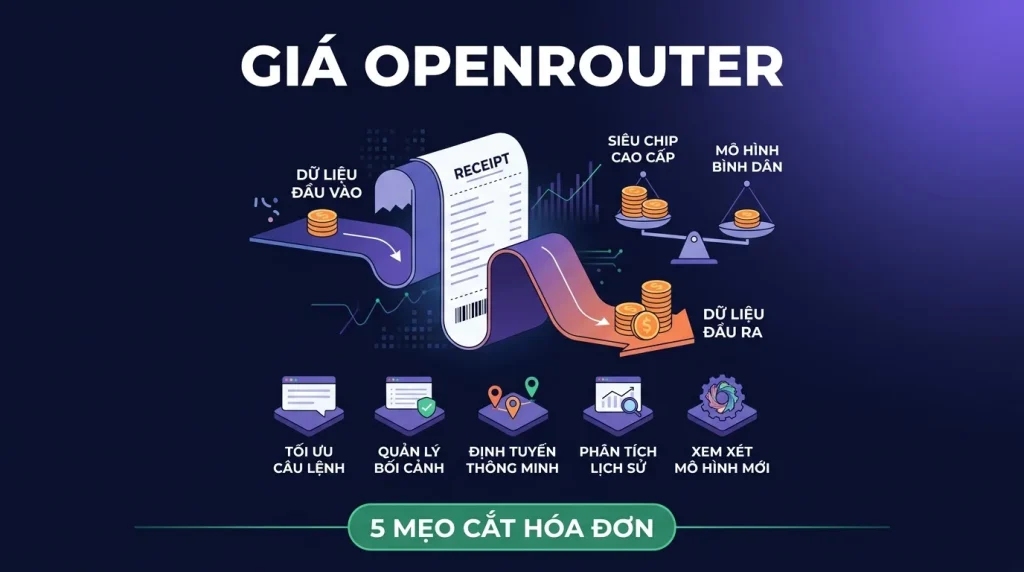
- Tiền = token vào × giá vào + token ra × giá ra, token ra thường đắt hơn hẳn
- Tiếng Việt tốn token hơn tiếng Anh ~1.5-2 lần, ước tính chi phí phải nhân hệ số này
- Model :free: hợp học và prototype; giới hạn lượt và không cam kết, đừng xây sản phẩm trên đó
- Chênh giá giữa model đỉnh và model mở tốt: hàng chục đến hàng trăm lần, chọn đúng cỡ việc là mẹo lớn nhất
- Việc đều đặn khối lượng lớn: điểm hòa vốn nghiêng về Ollama tự host khá sớm
Đọc bảng giá cho đúng: vào, ra và ngữ cảnh
Mỗi model niêm yết hai con số theo triệu token: input (đề bài: system prompt + lịch sử chat + tài liệu đính kèm) và output (câu trả lời, thường đắt gấp 3-5 lần input). Hai hệ quả ít người để ý: lịch sử chat là input lặp lại, hội thoại càng dài, mỗi lượt càng đắt vì cả cuộc trò chuyện được gửi lại; và tiếng Việt ăn token dày hơn tiếng Anh (mỗi chữ Việt bị băm thành nhiều token hơn), ước lượng chi phí từ tài liệu tiếng Anh phải nhân 1.5-2 lần. Trước khi chốt model cho một luồng, chạy 20 lượt thật rồi nhìn Activity, con số thật đáng tin hơn mọi phép nhân trên giấy.
Model free: món quà có điều kiện
Các model tag :free (thường là model mở do nhà cung cấp trợ giá) miễn phí thật, kèm ba điều kiện: giới hạn lượt theo ngày/phút khá chặt, không cam kết tồn tại lâu dài (model free hôm nay có thể biến mất tháng sau), và một số nhà cung cấp free dùng dữ liệu theo chính sách riêng, đọc kỹ trước khi đưa nội dung nhạy cảm. Kết luận thực dụng: free là sân tập tuyệt vời cho người học và prototype cuối tuần; sản phẩm có người dùng thật thì hoặc trả tiền model rẻ (rất nhiều model mở giá chỉ vài chục cent mỗi triệu token) hoặc tự host bằng Ollama.
5 mẹo cắt hóa đơn không giảm chất lượng
1. Phân tầng model theo việc, phân loại/trích xuất giao model mini-flash, chỉ việc chốt chất lượng mới gọi model đỉnh: mẹo lớn nhất, thường cắt quá nửa hóa đơn một mình nó. 2. Nén system prompt, prompt 2.000 chữ lặp lại mỗi lượt gọi là thuế cố định; viết lại còn 500 chữ giữ nguyên ý là giảm ngay phần input đó. 3. Chặn trần output, tham số max_tokens vừa đủ nhu cầu: câu trả lời phân loại không cần quyền viết 4.000 token. 4. Cắt lịch sử chat, giữ N lượt gần nhất + một đoạn tóm tắt thay vì gửi cả cuộc đời hội thoại. 5. Cache phía app, câu hỏi lặp (FAQ, mô tả sản phẩm) trả từ cache thay vì gọi lại model; Redis trên VPS làm việc này miễn phí.
Điểm hòa vốn với tự host: làm phép tính thật
Công thức so sánh: (token/tháng dự kiến × đơn giá model đang dùng) so với (tiền VPS RAM lớn/tháng). Ví dụ khung: một luồng phân loại + tóm tắt chạy đều đặn hàng chục nghìn lượt/tháng trên model trả phí cỡ vừa có thể tốn bằng hoặc hơn một VPS 16GB chạy qwen2.5:14b làm cùng việc đó không giới hạn lượt. Mô hình chín mà series này tuyên truyền: lai, Ollama gánh khối lượng, OpenRouter gánh chất lượng đỉnh, và ranh giới dịch chuyển dần về phía tự host khi lượng dùng tăng. Cách nối hai đường trong cùng một workflow đã có ở bài tích hợp.
Kỷ luật theo dõi: 10 phút mỗi tuần
Ba thói quen giữ hóa đơn ngoan: đặt credit limit trên từng key ngay lúc tạo, app lỗi lặp vô hạn hay key bị lộ đều bị trần chặn đứng; xem Activity theo app mỗi tuần (đã khai HTTP-Referer/X-Title theo bài tích hợp thì mỗi app một dòng rõ ràng), luồng nào chi tiêu tăng bất thường là thấy ngay; đặt ngưỡng cảnh báo số dư để không bao giờ gặp lỗi 402 giữa đêm. Nghe như quản trị tài chính hơn là lập trình, đúng vậy, và đó là kỹ năng phân biệt đội làm AI bền với đội bỏ cuộc sau cú sốc hóa đơn đầu tiên.
Tự ước chi phí trước khi chạy, bằng ba con số
# 1. Hoi thang so du va han muc hien tai
curl https://openrouter.ai/api/v1/auth/key -H "Authorization: Bearer $OPENROUTER_API_KEY"

# 2. Lay bang gia hien hanh cua tat ca model (gia doi theo thoi gian, dung chep cung vao dau)
curl -s https://openrouter.ai/api/v1/models | head -c 800

# 3. Sau moi lan goi, phan hoi tra ve so token thuc te da dung
#    doc truong usage trong ket qua: prompt_tokens, completion_tokens
Quy tắc ước nhanh cho tiếng Việt: lấy số ký tự chia cho khoảng 2,5 để ra số token, thay vì chia 4 như tiếng Anh. Một bài 1.000 từ tiếng Việt rơi vào khoảng 2.000 tới 2.500 token đầu ra.
Chi phí thật của một quy trình tự động, tính theo tháng
| Việc | Số lượt mỗi ngày | Token vào mỗi lượt | Token ra mỗi lượt | Ghi chú chi phí |
|---|---|---|---|---|
| Phân loại email đến | 200 | 800 | 50 | Đầu ra rất ngắn, dùng model rẻ nhất là đủ |
| Tóm tắt tài liệu | 20 | 6.000 | 500 | Đầu vào lớn, đây là nơi giá vào quyết định hóa đơn |
| Trả lời chatbot có lịch sử | 500 | 2.500 và tăng dần | 300 | Lịch sử chat gửi lại mỗi lượt, phải cắt bớt |
| Viết bài dài | 5 | 1.500 | 3.000 | Đầu ra lớn, chỉ ở đây mới đáng dùng model đắt |
Nhìn bảng sẽ thấy quy luật: việc nhiều lượt mà đầu ra ngắn thì chọn model rẻ; việc ít lượt mà đầu ra dài mới đáng trả tiền cho model tốt. Đặt ngược lại là cách tiêu tiền nhanh nhất.
Ba cách cắt hóa đơn hiệu quả nhất
- Chặn độ dài trả lời. Đặt giới hạn số token đầu ra ngay trong yêu cầu. Không đặt thì model có quyền viết dài gấp năm lần mức bạn cần, và bạn trả tiền cho phần thừa đó.
- Cắt lịch sử hội thoại. Chỉ giữ vài lượt gần nhất cộng một bản tóm tắt ngắn, thay vì gửi lại toàn bộ cuộc trò chuyện. Đây là nguồn phình chi phí âm thầm nhất của chatbot.
- Chia việc theo hai tầng. Model rẻ làm bước lọc và phân loại, model đắt chỉ xử lý phần đã lọc. Với luồng phân loại rồi trả lời, cách này thường cắt được quá nửa hóa đơn.
Khi nào tự host đáng tiền
Phép tính đơn giản: lấy chi phí gọi dịch vụ trong 30 ngày gần nhất, so với chi phí thuê một máy chủ đủ chạy mô hình mở. Nếu công việc đều đặn cả ngày và không đòi model mạnh nhất, mốc hòa vốn thường đến sớm hơn nhiều người tưởng. Nếu tải thất thường, vài chục lượt hôm nay và vài nghìn lượt tuần sau, thì trả theo lượt vẫn rẻ hơn.
Một yếu tố ngoài tiền cần cân: dữ liệu. Tài liệu nội bộ, hồ sơ khách hàng và mã nguồn riêng gửi ra dịch vụ ngoài là một quyết định về dữ liệu, không chỉ về chi phí. Chi tiết cấu hình máy nằm ở bài Ollama cần bao nhiêu RAM và trang VPS NVMe.
Câu hỏi thường gặp
Nạp tối thiểu bao nhiêu và tiền có hết hạn không?
Mức nạp tối thiểu thấp (vài USD), kiểm tra con số hiện hành trên trang thanh toán vì chính sách có thể đổi. Credit nằm trong ví đến khi dùng; phụ phí tính lúc nạp chứ không trừ dần.
Cùng một model, giá trên OpenRouter có đắt hơn gọi thẳng hãng không?
Đơn giá token thường bằng niêm yết của hãng; phần chênh là phụ phí lúc nạp tiền. Đổi lại được một ví chung, một API, một dashboard, với người dùng nhiều model, phần tiện thường thắng phần phí.
Ước lượng token cho tiếng Việt thế nào cho nhanh?
Ước thô: 1 chữ tiếng Việt ≈ 1.5-2 token (tiếng Anh ≈ 0.75 token/từ). Chuẩn nhất là gọi thử 10 lượt thật rồi đọc con số usage trong response, mọi ước lượng giấy đều thua số đo.
Có cách nào biết model rẻ có đủ tốt cho việc của tôi không?
Bộ câu thử cố định, đúng phương pháp của bài chọn model Ollama: 10-20 câu thật của nghiệp vụ, chạy qua 3 mức giá model, chấm bằng mắt. Rất thường xuyên model rẻ hơn 10 lần cho kết quả đủ dùng, nhưng chỉ bộ thử của bạn nói được điều đó.