
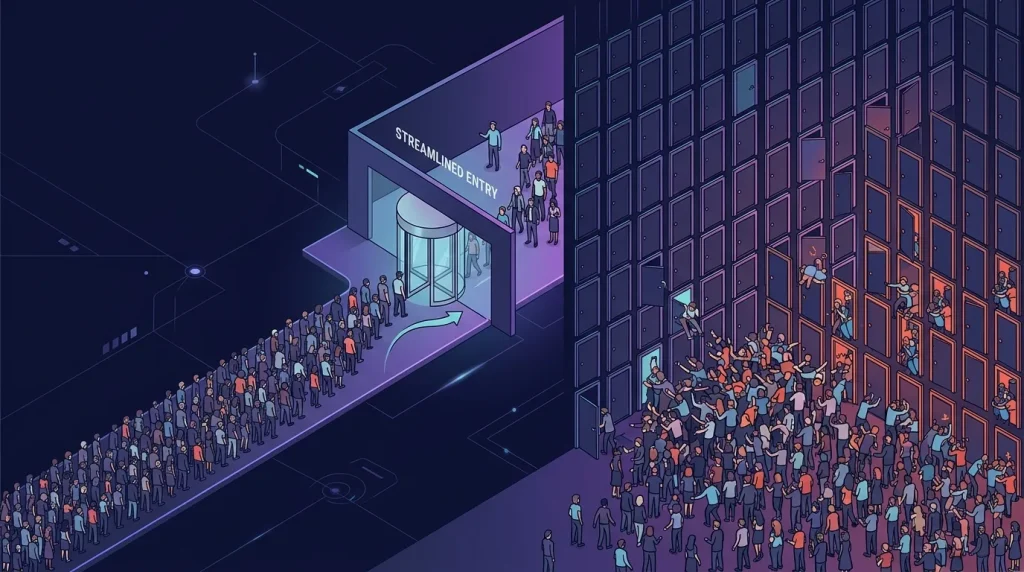
Trả lời nhanh: Mỗi kết nối database là một tiến trình/luồng thật phía server, tốn vài MB RAM và hàng chục mili-giây bắt tay để dựng. App mở kết nối mới cho từng request sẽ nghẹt database ở vài trăm kết nối dù CPU còn rảnh. Connection pool giải bài này: giữ sẵn một nhóm kết nối (thường chỉ 10-20) và cho hàng nghìn request mượn xoay vòng. Phản trực giác nhưng đúng: pool nhỏ chảy nhanh hơn pool to, công thức khởi điểm: số nhân CPU × 2-4.
"Sorry, too many clients" / "max_connections reached" lúc 20h tối là nghi thức trưởng thành của mọi backend dev. Bài này giải thích tận gốc vì sao kết nối database đắt, pool hoạt động ra sao, cỡ pool bao nhiêu là đúng (gợi ý: nhỏ hơn bạn tưởng nhiều), và khi nào cần đến pooler đứng riêng như pgbouncer.
- Kết nối = tài nguyên đắt: RAM mỗi kết nối + bắt tay TCP/TLS/auth mỗi lần mở
- Pool giữ 10-20 kết nối sống, hàng nghìn request mượn - trả xoay vòng
- Cỡ pool: nhân CPU × 2-4; to hơn không nhanh hơn mà chỉ chen lấn hơn
- Serverless/nhiều instance → pooler trung gian (pgbouncer) đứng chắn trước database
Vì sao kết nối đắt thế
Phía Postgres, mỗi kết nối là một tiến trình fork riêng ăn vài MB; MySQL mỗi kết nối một luồng. Mở mới còn trả thêm phí bắt tay: TCP, TLS, xác thực, khởi tạo phiên, cộng lại hàng chục mili-giây trước khi query đầu tiên chạy. Nghĩa là kiểu code "mỗi request tự mở rồi đóng" đang: trả phí bắt tay đắt hơn chính query, và thổi số tiến trình database theo lượng khách, đến max_connections (mặc định Postgres: 100) là sập cửa với người đến sau, kể cả khi CPU và ổ còn rảnh rang. Bệnh của kiến trúc, không phải của phần cứng.
Pool: xoay vòng thay vì xây mới
Pool mở sẵn N kết nối lúc app khởi động và giữ chúng sống. Request đến → mượn một kết nối rảnh → chạy query vài mili-giây → trả lại. Một kết nối phục vụ hàng trăm request mỗi giây theo kiểu xoay vòng, 1.000 người dùng đồng thời thường chỉ cần 10-20 kết nối thật, vì tại một khoảnh khắc chỉ chừng đó query đang thực thi.
Tin tốt: mọi framework hiện đại có pool sẵn, Prisma/Drizzle, SQLAlchemy, Laravel, Spring... Việc của bạn không phải viết pool mà là đặt đúng cỡ và không rò rỉ (mượn mà quên trả, thường do quên đóng transaction; pool cạn dần rồi treo app, log hiện "timeout acquiring connection").
Cỡ pool: nghịch lý nhỏ-mà-nhanh
Trực giác bảo pool 200 phục vụ tốt hơn pool 20, thực nghiệm ngành nói ngược lại: database chỉ làm song song hiệu quả cỡ số nhân CPU (cộng chút chờ I/O); 200 query cùng chen chỉ tạo cảnh tranh khóa, tranh cache, context-switch, tổng thông lượng giảm. Công thức khởi điểm kinh điển:
pool_size ≈ so_nhan_CPU × 2   (may database rieng)
# VPS 6 nhan → pool 12-16 la vung ngot; do roi chinh, dung doan
Nhiều app instance cùng trỏ một database? Tổng của mọi pool mới là con số database gánh, 4 instance × pool 20 = 80 kết nối. Đây là lúc cần tầng tiếp theo.
pgbouncer: pool đứng riêng chắn trước database
Khi app nhiều instance (hoặc serverless, mỗi invocation một kết nối tiềm năng), đặt pgbouncer làm trạm gác: app trỏ vào pgbouncer, pgbouncer giữ vài chục kết nối thật đến Postgres và múc chung cho tất cả. Chế độ transaction pooling cho hiệu suất chia sẻ cao nhất (một kết nối thật phục vụ nhiều client xen kẽ theo từng transaction). Cài trên cùng VPS database, cấu hình 20 dòng, bài toán "3 app + n8n + vài worker cùng một Postgres" của dân self-host được giải gọn bằng đúng công cụ này.
Tính cỡ bể kết nối, và vì sao nhỏ lại nhanh hơn
# Xem gioi han hien tai va so ket noi dang mo
psql -c "SHOW max_connections;"
psql -c "SELECT count(*), state FROM pg_stat_activity GROUP BY state;"

# Ket noi nao dang treo lau, thu pham thuong gap
psql -c "SELECT pid, state, now()-query_start AS chay_bao_lau, left(query,60)
         FROM pg_stat_activity WHERE state <> 'idle'
         ORDER BY chay_bao_lau DESC LIMIT 10;"

# Bo nho moi ket noi chiem
psql -c "SHOW work_mem;"| Số nhân của máy | Cỡ bể hợp lý | Ghi chú |
|---|---|---|
| 2 nhân | khoảng 5 tới 6 | Nghe ít nhưng đúng |
| 4 nhân | khoảng 9 tới 12 | |
| 8 nhân | khoảng 17 tới 20 | |
| Bất kỳ | Không quá vài chục | Trên mức đó, thêm kết nối làm chậm chứ không nhanh hơn |
Nghịch lý nhỏ mà nhanh: mỗi kết nối là một tiến trình riêng, chiếm bộ nhớ và tranh nhau vi xử lý. Hai trăm kết nối trên máy 4 nhân nghĩa là hệ điều hành phải liên tục chuyển qua lại giữa hai trăm tiến trình, và phần lớn thời gian trôi vào việc chuyển đó chứ không vào việc chạy truy vấn.
Đặt bể ở đâu
| Tình huống | Đặt ở đâu | Ghi chú |
|---|---|---|
| Một ứng dụng, một tiến trình | Trong chính ứng dụng | Đơn giản nhất, đủ dùng |
| Nhiều tiến trình ứng dụng trên một máy | Bể đứng riêng trước cơ sở dữ liệu | Nếu không, mỗi tiến trình có bể riêng và tổng vượt giới hạn |
| Nhiều máy chủ ứng dụng | Bể đứng riêng, bắt buộc | Đây là lý do chính người ta dựng nó |
| Ứng dụng chạy dạng hàm, mỗi lượt một tiến trình mới | Bể đứng riêng, ở chế độ dùng chung theo giao dịch | Không có bể thì mỗi lượt gọi mở kết nối mới, cơ sở dữ liệu sập rất nhanh |
Ba dấu hiệu bể đang sai cỡ
- Ứng dụng báo hết kết nối trong giờ cao điểm trong khi vi xử lý của máy cơ sở dữ liệu vẫn nhàn: bể quá nhỏ so với số tiến trình, hoặc có kết nối bị giữ mà không trả lại.
- Nhiều kết nối ở trạng thái chờ trong giao dịch: ứng dụng mở giao dịch rồi làm việc khác trước khi đóng. Đây là lỗi trong mã, không phải lỗi cấu hình.
- Cơ sở dữ liệu chậm đều mọi truy vấn khi đông người: quá nhiều kết nối đang tranh nhau. Giảm cỡ bể thường làm mọi thứ nhanh lên, ngược với trực giác.
Câu hỏi thường gặp
Lỗi 'too many clients already' xử lý ngay thế nào?
Ngắn hạn: restart app rò rỉ, tăng tạm max_connections. Đúng cách: tìm chỗ mở kết nối ngoài pool, đặt lại cỡ pool theo công thức, cân nhắc pgbouncer khi nhiều instance. Tăng max_connections mãi chỉ là nhét thêm ghế vào phòng đã chật.
SQLite có cần connection pool không?
Không theo nghĩa này, SQLite nằm trong tiến trình app, không có chi phí kết nối mạng. Mối quan tâm của nó là khóa ghi (bài SQLite production đã nói).
Pool có làm chậm request đầu tiên sau khi app khởi động không?
Có thể ấm máy vài giây khi pool mở loạt kết nối đầu. Nhiều pool hỗ trợ min_connections mở sẵn lúc boot, đặt bằng cỡ pool luôn cho ấm từ đầu.
Máy mạnh hơn có thay được pool không?
Không, nghẽn kết nối là bệnh kiến trúc. Nhưng máy tử tế làm pool nhỏ phát huy trọn: query xong nhanh (CPU xung cao + NVMe) thì kết nối được trả nhanh, cùng pool 15 phục vụ được gấp bội request.