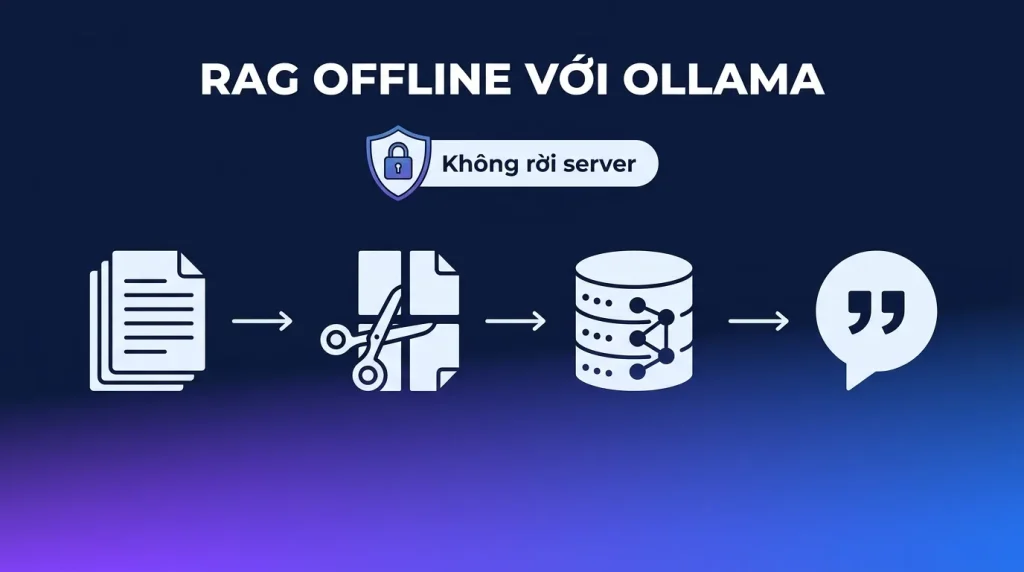
Trả lời nhanh: RAG (Retrieval-Augmented Generation) = cho model tra cứu tài liệu của bạn trước khi trả lời, hết bịa, có nguồn. Bản offline trọn gói: Ollama chạy model chat + model embeddings, pgvector hoặc Qdrant làm kho vector, tất cả trên một VPS, câu hỏi lẫn tài liệu không bao giờ rời máy. Đường nhanh nhất không cần code: Open WebUI có RAG cài sẵn, kéo thả tài liệu là hỏi được.
Hỏi đáp trên chính tài liệu công ty, hợp đồng, quy trình, catalog sản phẩm, là ứng dụng AI thực dụng nhất với doanh nghiệp Việt, và cũng là ứng dụng nhạy cảm nhất về dữ liệu: đưa hồ sơ khách lên dịch vụ AI nước ngoài là điều nhiều công ty không được phép làm. RAG offline giải cả hai vế. Bài này ghép các mảnh đã có trên blog TND thành kiến trúc hoàn chỉnh, cho hai đường triển khai theo trình độ, và phần ít bài nào nói: vì sao RAG trả lời dở và cách chữa.
- RAG = tìm đoạn tài liệu liên quan (bằng vector) rồi đưa cho model đọc trước khi trả lời
- 4 mảnh đều tự host được: model chat + model embeddings (Ollama) + kho vector + pipeline nạp tài liệu
- Đường không code: Open WebUI kéo thả tài liệu; đường có code: LangChain/LlamaIndex + pgvector
- Chất lượng RAG nằm ở khâu cắt tài liệu và tìm kiếm nhiều hơn ở cỡ model
- I/O là hạ tầng của RAG: index vector + đọc tài liệu = đúng đất của NVMe
RAG hoạt động thế nào, một đoạn là hiểu
Model không thể biết nội quy công ty bạn, nhưng nó đọc hiểu rất giỏi. RAG khai thác đúng điều đó theo hai pha. Pha nạp (làm một lần): tài liệu được cắt thành đoạn nhỏ, mỗi đoạn đi qua model embeddings thành một vector (dãy số đại diện ngữ nghĩa), cất vào kho vector. Pha hỏi (mỗi câu hỏi): câu hỏi cũng thành vector, kho tìm các đoạn gần nghĩa nhất, các đoạn đó được nhét vào prompt cùng câu hỏi, model chỉ việc đọc và trả lời dựa trên đoạn được đưa, kèm khả năng trích nguồn. Không huấn luyện lại gì cả, thêm tài liệu mới chỉ là nạp thêm vào kho.
Bốn mảnh của bản offline trọn gói
Model chat: qwen2.5:14b là điểm cân cho tiếng Việt (chọn kỹ hơn theo bài chọn model), nhớ nâng num_ctx lên 8k-16k vì các đoạn tài liệu ăn ngữ cảnh. Model embeddings: nomic-embed-text qua chính Ollama, nhẹ, đa ngữ đủ dùng. Kho vector: hai trường phái đã có bài riêng, pgvector (thêm extension vào Postgres sẵn có, đỡ một dịch vụ) và Qdrant (chuyên dụng, mạnh khi triệu vector). Pipeline nạp: thứ quyết định thành bại, phần riêng bên dưới.
Hai đường triển khai theo trình độ
Đường 1, không cần code (chiều thứ bảy là xong): Open WebUI có RAG tích hợp: vào Workspace → Knowledge, kéo thả PDF/Word/text, gắn bộ tài liệu vào cuộc chat là hỏi đáp được ngay, có trích nguồn. Đủ tốt cho cá nhân và đội nhỏ dùng nội bộ. Đường 2, có code, kiểm soát trọn: LangChain hoặc LlamaIndex nối Ollama + pgvector, tự quyết cách cắt đoạn, lọc metadata, format trích dẫn, nền cho chatbot gắn vào website hay app riêng. Kiến trúc mẫu với code đã có ở bài RAG pipeline Postgres + pgvector, thay lớp gọi Claude bằng ChatOllama là thành bản offline thuần.
Vì sao RAG trả lời dở, và chữa ở đâu
Kinh nghiệm xương máu: khi RAG dở, 8/10 lần lỗi ở khâu tìm chứ không phải khâu trả lời, model không thể đúng khi được đưa sai đoạn. Ba núm vặn theo thứ tự: cách cắt đoạn, đoạn 300-800 token, cắt theo ranh giới mục/đề mục thay vì đếm ký tự cứng, giữ tiêu đề mục trong mỗi đoạn để vector mang ngữ cảnh; số đoạn lấy, lấy top 4-6 thay vì 2, kèm ngưỡng điểm để loại rác; câu lệnh hệ thống, bắt model chỉ trả lời từ tài liệu được đưa, thiếu thì nói thiếu, và luôn dẫn tên tài liệu. Đo chất lượng bằng bộ 20 câu hỏi thật của nghiệp vụ trước và sau mỗi lần chỉnh, cảm tính là kẻ thù của RAG.
Hạ tầng: RAG ăn I/O nhiều hơn bạn nghĩ
Khác chat thuần (ăn CPU/RAM), RAG cộng thêm tải I/O rõ rệt: tìm kiếm vector đọc index, pha nạp xử lý cả kho tài liệu, Postgres ghi liên tục, với hàng chục nghìn đoạn trở lên, độ trễ ổ đĩa hiện thẳng vào thời gian chờ câu trả lời (số đo IOPS cụ thể trong bài pgvector). Cấu hình khởi điểm cho đội nhỏ: VPS 16GB RAM (14B + embeddings + Postgres), NVMe cho index, num_ctx 8k; và như bài trước dặn, cả cụm sống trong tailnet, không cổng nào phơi ra ngoài.
Cấu hình cắt tài liệu, phần quyết định chất lượng
Chất lượng hỏi đáp tài liệu nằm ở khâu cắt và tìm kiếm nhiều hơn ở cỡ model. Ba tham số cần chỉnh và mốc nên bắt đầu:
| Tham số | Mốc nên dùng | Ảnh hưởng |
|---|---|---|
| Kích thước đoạn | 500 tới 800 ký tự cho văn bản tiếng Việt | Đoạn quá dài làm loãng ngữ nghĩa, quá ngắn thì mất ngữ cảnh |
| Phần chồng lấn giữa hai đoạn | 10 tới 15% kích thước đoạn | Chống việc câu trả lời nằm vắt qua ranh giới hai đoạn |
| Số đoạn lấy về cho mỗi câu hỏi | 4 tới 8 | Lấy quá nhiều làm model lạc, quá ít thì thiếu dữ kiện |
| Ngưỡng độ tương đồng | 0,7 trở lên với cosine | Dưới ngưỡng thì thà trả lời không tìm thấy còn hơn bịa |
Với tài liệu có cấu trúc rõ như quy trình hay hợp đồng, cắt theo mục thay vì cắt theo số ký tự cho kết quả tốt hơn hẳn. Giữ tiêu đề mục vào đầu mỗi đoạn cũng là mẹo rẻ tiền mà hiệu quả.
Kiểm hệ thống trả lời đúng hay đang bịa
# 1. Tao bo cau hoi kiem thu co dap an biet truoc, it nhat 20 cau
# 2. Voi moi cau, ghi lai: co tra loi dung khong, co trich dung doan tai lieu khong

# Kiem model nhung hoat dong
curl http://localhost:11434/api/embeddings -d @cau-hoi.json | head -c 200

# Kiem kho vector co du lieu chua (voi pgvector)
psql -d rag -c "SELECT count(*) FROM documents;"
psql -d rag -c "SELECT left(content,80) FROM documents ORDER BY embedding <=> (SELECT embedding FROM documents LIMIT 1) LIMIT 5;"
Ba lỗi hay gặp khi kết quả kém: nạp tài liệu nhưng quên tạo lại chỉ mục vector, dùng model nhúng khác lúc nạp và lúc hỏi, và cắt đoạn quá dài. Kiểm theo đúng thứ tự đó.
Dữ liệu nhạy cảm: ba việc bắt buộc
- Phân quyền theo người hỏi. Hệ thống hỏi đáp dễ trở thành cửa sau: nhân viên không được xem bảng lương vẫn hỏi được nếu tài liệu đó nằm chung kho. Gắn nhãn quyền cho từng tài liệu và lọc trước khi tìm kiếm, không lọc sau.
- Ghi nhật ký câu hỏi. Biết ai hỏi gì, vừa để cải thiện vừa để truy vết khi có sự cố.
- Đừng để cổng của model mở ra internet. Xem lại phần mở dịch vụ an toàn, vì kho vector và model đều không có lớp xác thực riêng.
Về pháp lý: Luật Bảo vệ dữ liệu cá nhân 91/2025/QH15 có hiệu lực từ 01/01/2026 yêu cầu biện pháp bảo vệ phù hợp khi xử lý dữ liệu cá nhân. Chạy toàn bộ trên máy chủ của công ty và có nhật ký truy cập là cách dễ chứng minh nhất khi được hỏi.
Phần cứng theo quy mô tài liệu
| Khối lượng tài liệu | RAM | Ổ đĩa | Ghi chú |
|---|---|---|---|
| Dưới 1.000 trang | 8 GB | NVMe 40 GB | Model 7 tới 8 tỉ tham số là đủ |
| 1.000 tới 10.000 trang | 16 GB | NVMe 100 GB | Chỉ mục vector bắt đầu đáng kể, cần ổ nhanh |
| Trên 10.000 trang | 32 GB trở lên | NVMe 200 GB trở lên | Cân nhắc tách kho vector sang máy riêng |
Câu hỏi thường gặp
RAG khác gì fine-tune model trên dữ liệu công ty?
RAG tra cứu lúc chạy, thêm sửa tài liệu là có hiệu lực ngay, trích được nguồn, không cần GPU huấn luyện. Fine-tune dạy model văn phong/kỹ năng mới nhưng tốn công, khó cập nhật và dễ bịa hơn khi hỏi chi tiết. Nhu cầu hỏi đáp tài liệu: RAG đúng bài hơn hầu hết trường hợp.
Tài liệu tiếng Việt dùng embeddings nào?
nomic-embed-text qua Ollama xử tiếng Việt ở mức dùng được cho đa số kho tài liệu nội bộ. Kho lớn đòi độ chính xác cao có thể thử model embeddings đa ngữ chuyên hơn, nguyên tắc thử bằng bộ câu hỏi thật vẫn áp dụng.
Bao nhiêu tài liệu thì pgvector không đủ, phải sang Qdrant?
pgvector êm tới hàng trăm nghìn vector với index HNSW trên máy tử tế, đa số doanh nghiệp nhỏ không bao giờ chạm trần này. Cân nhắc Qdrant khi vượt hàng triệu vector, cần lọc metadata phức tạp hiệu năng cao, hoặc muốn tách dịch vụ vector khỏi database chính.
Người dùng hỏi bằng Zalo/website có nối vào RAG này được không?
Được, RAG phơi ra như một API (qua đường 2, hoặc API của Open WebUI), rồi n8n làm cầu nối kênh chat vào API đó. Toàn bộ vẫn chạy trên hạ tầng của bạn; chỉ tin nhắn đi qua nền tảng chat như bình thường.