
- RAG (Retrieval Augmented Generation) cho phép Claude trả lời từ knowledge base riêng của bạn.
- Stack đề xuất 2026: Postgres 16 + pgvector 0.7, embedding voyage-3 (Anthropic), LLM Claude Sonnet 4.7.
- VPS 4GB RAM chạy được full stack cho 100k document, query latency 200-500ms.
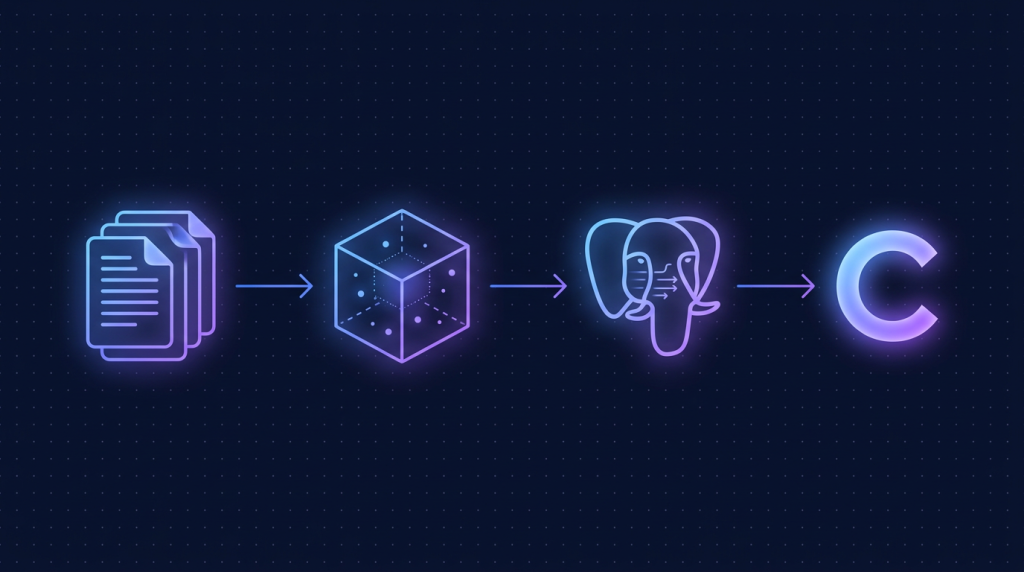
- Pipeline: ingest -> chunk -> embed -> store pgvector -> query embed -> kNN search -> stuff Claude.
- Chi phí: VPS 350k + embedding ~5-15$/tháng + Claude API ~10-30$/tháng cho team nhỏ.
RAG (Retrieval Augmented Generation) là kỹ thuật quan trọng nhất để xây chatbot domain-specific 2026. Thay vì fine-tune model, bạn giữ LLM mặc định và "stuff" context liên quan vào prompt mỗi lần query. Ưu điểm: cập nhật knowledge dễ (chỉ re-index), không tốn GPU train, accuracy cao.
Bài này hướng dẫn build RAG pipeline production-ready từ A-Z với Postgres pgvector (extension Postgres add vector type) + Claude API. Lý do chọn pgvector: free, mature, query SQL quen thuộc, single DB cho cả structured + vector data, dễ backup. Lý do chọn Claude: context dài 200k token, hiểu tiếng Việt tốt, output structured JSON ổn định.
Mục tiêu cuối bài: bạn có RAG service chạy trên VPS, ingest 1000+ document Markdown/PDF, expose API /query nhận câu hỏi và trả answer + citation. Tổng setup 45-60 phút. Total cost 400-500k/tháng cho khối lượng 1000-5000 query/ngày.
1. RAG là gì và khi nào nên dùng?
RAG = Retrieval + Generation. Khi user hỏi, hệ thống:
- Embed câu hỏi thành vector (number array 1024 chiều).
- Tìm top-K document gần nhất trong DB (kNN cosine similarity).
- Đưa K document + câu hỏi vào prompt LLM, yêu cầu trả lời dựa trên context.
- LLM tạo answer + cite source.
Khi nào dùng: chatbot internal company FAQ, search docs developer, customer support trên product knowledge, summary research paper, Q&A trên contract/legal text. Khi không nên dùng: task cần reasoning toàn cục (compare 100 doc), realtime conversational (latency cao hơn LLM trực tiếp).
2. Vì sao chọn pgvector thay vì Qdrant/Pinecone?
| Tiêu chí | pgvector (Postgres) | Qdrant self-host | Pinecone cloud |
|---|---|---|---|
| Chi phí 100k vector | VPS 4GB ~350k | VPS 4GB ~350k | 70$/tháng Starter |
| Query SQL JOIN | Native | Cần app layer | Không |
| Index HNSW | Có (0.5+) | Có | Có |
| Backup | pg_dump quen thuộc | Snapshot Qdrant | Managed |
| Performance 1M vector | 500ms p95 | 50ms p95 | 30ms p95 |
pgvector phù hợp 90% project <500k vector. Đơn giản, ổn định, backup dễ. Qdrant/Pinecone chỉ thắng khi cần scale >1M vector với latency <100ms.
3. Yêu cầu VPS
- RAM: 4GB tối thiểu (Postgres 1.5GB + Python app 500MB + buffer). 8GB cho dataset >100k doc.
- vCPU: 2-4. Vector search dùng SIMD nên CPU mới (AVX2/AVX512) nhanh hơn 2x.
- SSD: 40-100GB. Mỗi embedding 1024 float32 = 4KB. 100k doc ~400MB; 1M ~4GB.
- OS: Ubuntu 24.04 LTS. Docker để dễ deploy.
4. Cài Postgres 16 + pgvector qua Docker
# Cài Docker
curl -fsSL https://get.docker.com | sh

mkdir -p /opt/rag/{pgdata,app}
cd /opt/rag
# docker-compose.yml
services:
postgres:
image: pgvector/pgvector:pg16
restart: unless-stopped
environment:
POSTGRES_DB: rag
POSTGRES_USER: rag
POSTGRES_PASSWORD: $POSTGRES_PASSWORD
volumes:
- ./pgdata:/var/lib/postgresql/data
ports:
- "127.0.0.1:5432:5432"
command: postgres -c shared_buffers=512MB -c work_mem=16MB
app:
build: ./app
restart: unless-stopped
environment:
DATABASE_URL: postgresql://rag:$POSTGRES_PASSWORD@postgres:5432/rag
ANTHROPIC_API_KEY: $ANTHROPIC_API_KEY
VOYAGE_API_KEY: $VOYAGE_API_KEY
depends_on: [postgres]
ports:
- "8000:8000"5. Schema Postgres + pgvector
-- schema.sql
CREATE EXTENSION IF NOT EXISTS vector;

CREATE TABLE documents (
  id BIGSERIAL PRIMARY KEY,
  source TEXT NOT NULL,
  title TEXT,
  url TEXT,
  created_at TIMESTAMPTZ DEFAULT now()
);

CREATE TABLE chunks (
  id BIGSERIAL PRIMARY KEY,
  document_id BIGINT REFERENCES documents(id) ON DELETE CASCADE,
  chunk_index INT NOT NULL,
  content TEXT NOT NULL,
  token_count INT,
  embedding vector(1024),
  created_at TIMESTAMPTZ DEFAULT now()
);

CREATE INDEX chunks_embedding_idx ON chunks
USING hnsw (embedding vector_cosine_ops)
WITH (m=16, ef_construction=64);

CREATE INDEX chunks_document_idx ON chunks(document_id);
vector(1024) phù hợp với voyage-3 embedding của Anthropic. Nếu dùng OpenAI text-embedding-3-small thì vector(1536), large là 3072.
6. Ingest pipeline Python
# app/ingest.py
import os, voyageai, psycopg2
from pypdf import PdfReader

vo = voyageai.Client(api_key=os.environ["VOYAGE_API_KEY"])
conn = psycopg2.connect(os.environ["DATABASE_URL"])

def chunk_text(text, size=512, overlap=64):
    chunks = []
    i = 0
    while i < len(text):
        chunks.append(text[i:i+size])
        i += size - overlap
    return chunks

def ingest_file(path, source, title):
    if path.endswith(".pdf"):
        reader = PdfReader(path)
        text = "n".join(p.extract_text() or "" for p in reader.pages)
    else:
        text = open(path).read()

    chunks = chunk_text(text)
    embeddings = vo.embed(chunks, model="voyage-3", input_type="document").embeddings

    cur = conn.cursor()
    cur.execute("INSERT INTO documents (source, title) VALUES (%s, %s) RETURNING id",
                (source, title))
    doc_id = cur.fetchone()[0]
    for idx, (content, emb) in enumerate(zip(chunks, embeddings)):
        cur.execute(
            "INSERT INTO chunks (document_id, chunk_index, content, embedding) "
            "VALUES (%s, %s, %s, %s)",
            (doc_id, idx, content, emb)
        )
    conn.commit()
    print(f"Ingested {len(chunks)} chunks from {path}")
7. Query API với FastAPI
# app/main.py
import os, voyageai, psycopg2, anthropic
from fastapi import FastAPI
from pydantic import BaseModel

vo = voyageai.Client(api_key=os.environ["VOYAGE_API_KEY"])
claude = anthropic.Anthropic(api_key=os.environ["ANTHROPIC_API_KEY"])
conn = psycopg2.connect(os.environ["DATABASE_URL"])
app = FastAPI()

class Query(BaseModel):
    question: str
    top_k: int = 5

@app.post("/query")
def query(q: Query):
    # 1. Embed question
    q_emb = vo.embed([q.question], model="voyage-3", input_type="query").embeddings[0]

    # 2. kNN search top_k chunks
    cur = conn.cursor()
    cur.execute(
        "SELECT c.content, d.title, d.source "
        "FROM chunks c JOIN documents d ON d.id = c.document_id "
        "ORDER BY c.embedding <=> %s::vector LIMIT %s",
        (q_emb, q.top_k)
    )
    rows = cur.fetchall()

    # 3. Build context
    context = "nn".join(
        f"[Source: {r[2]} - {r[1]}]n{r[0]}" for r in rows
    )

    # 4. Call Claude
    msg = claude.messages.create(
        model="claude-sonnet-4-7-20260301",
        max_tokens=1024,
        messages=[{
            "role": "user",
            "content": f"Dựa trên context sau, trả lời câu hỏi và cite source.nnCONTEXT:n{context}nnCÂU HỎI: {q.question}"
        }]
    )

    return {
        "answer": msg.content[0].text,
        "sources": [{"title": r[1], "source": r[2]} for r in rows]
    }
8. Dockerfile cho app
# app/Dockerfile
FROM python:3.12-slim
WORKDIR /app
COPY requirements.txt .
RUN pip install --no-cache-dir -r requirements.txt
COPY . .
CMD ["uvicorn", "main:app", "--host", "0.0.0.0", "--port", "8000"]
# app/requirements.txt
fastapi==0.115.0
uvicorn[standard]==0.32.0
psycopg2-binary==2.9.10
voyageai==0.3.0
anthropic==0.40.0
pypdf==5.0.0
pgvector==0.3.49. Test ingest và query
docker compose up -d
docker compose exec postgres psql -U rag -f /schema.sql

# Ingest 1 PDF
docker compose exec app python -c "
from ingest import ingest_file
ingest_file('docs/handbook.pdf', 'company', 'Employee Handbook')
"

# Query
curl -X POST http://1.2.3.4:8000/query
  -H "Content-Type: application/json"
  -d '{"question": "Quy trình xin nghỉ phép như thế nào?", "top_k": 5}'
10. Tối ưu performance
- HNSW index parameters: m=16, ef_construction=64 cho dataset <500k chunk. Tăng m=32 cho >1M.
- Batch embedding: voyageai client cho phép batch 128 chunk/request, giảm 5-10x cost API call.
- Cache query embedding: Redis lưu hash(question) -> embedding, giảm 50% API call cho query repeat.
- Reranker: thêm bước rerank top 20 bằng Cohere/voyage-rerank, lọc lại top 5 chính xác hơn 30-40%.
- Postgres: tăng shared_buffers lên 25% RAM (1GB cho VPS 4GB), enable parallel query.
11. Embedding model so sánh
| Model | Dim | Cost / 1M token | Tiếng Việt |
|---|---|---|---|
| voyage-3 (Anthropic) | 1024 | 0.06$ | Tốt |
| OpenAI text-embedding-3-small | 1536 | 0.02$ | Tốt |
| OpenAI text-embedding-3-large | 3072 | 0.13$ | Rất tốt |
| BGE-M3 (open source) | 1024 | 0$ (self-host CPU) | Tốt |
| nomic-embed-text v1.5 | 768 | 0$ (Ollama) | Trung bình |
Mình dùng voyage-3 cho production vì pair tốt với Claude, cùng vendor Anthropic. Self-host BGE-M3 trên Ollama nếu cần offline 100%.
12. Monitor và evaluate RAG quality
- Log mọi query + answer + sources vào Postgres table queries.
- Set up Grafana dashboard: latency p50/p95, top question, source được cite nhất.
- Eval định kỳ: chọn 50 question test với golden answer, đo recall@5, MRR.
- User feedback: thêm thumbs up/down trên UI, retrain prompt từ negative feedback.
VPS 4-8GB chạy RAG pipeline với pgvector + Claude
Cloud VPS TND AMD EPYC AVX-512, SSD CEPH NVMe, snapshot 1-click, backup hằng ngày, network 200Mbps. CPU mới hỗ trợ SIMD tăng tốc pgvector 2x. Đủ resource cho Postgres + FastAPI service + 500k embedding chunk.
Xem 8 cấu hình Cloud VPS →Ba việc quyết định chất lượng, quan trọng hơn việc chọn công nghệ
| Việc | Vì sao quyết định | Cách làm |
|---|---|---|
| Chia tài liệu cho hợp lý | Chia quá nhỏ thì mất ngữ cảnh, quá lớn thì kết quả loãng | Thử vài kích thước trên chính tài liệu của bạn rồi so kết quả |
| Lọc trước khi tìm theo ngữ nghĩa | Giảm nhiễu và giảm chi phí cùng lúc | Lọc theo nguồn, theo thời gian, theo loại tài liệu |
| Đo chất lượng bằng bộ câu hỏi cố định | Không đo thì mọi chỉnh sửa là đoán mò | Chuẩn bị 30 tới 50 câu hỏi thật kèm câu trả lời đúng |
Việc thứ ba là việc bị bỏ qua nhiều nhất và cũng quan trọng nhất: không có bộ câu hỏi kiểm chứng thì bạn không biết thay đổi vừa rồi làm hệ thống tốt lên hay tệ đi. Chuẩn bị bộ này trước khi tối ưu bất cứ thứ gì.
Yêu cầu máy chủ và cách ước
# Uoc dung luong phan vector
# so ban ghi nhan so chieu nhan 4 byte, cong 30 den 50% cho chi muc

# Do that sau khi nap du lieu
psql -c "SELECT pg_size_pretty(pg_total_relation_size('ten_bang'));"

# Ty le doc trung bo nho dem: duoi 95% la dang xuong o dia nhieu
psql -c "SELECT round(100.0*sum(blks_hit)/nullif(sum(blks_hit)+sum(blks_read),0),2)
         FROM pg_stat_database;"

# Chay lai thong ke sau khi nap du lieu lon, buoc hay bi quen
psql -c "ANALYZE;"
Ngưỡng cần biết: khi chỉ mục còn nằm gọn trong bộ nhớ, tìm kiếm rất nhanh. Khi vượt bộ nhớ, mỗi lần tìm phải đọc từ ổ, và đó là lúc ổ NVMe tạo khác biệt lớn. Thứ tự nâng cấp đúng: thêm bộ nhớ trước, đổi ổ nhanh sau.
Ba lỗi hay gặp khi đưa vào chạy thật
- Không giới hạn độ dài phần bối cảnh đưa vào mô hình. Đây là khoản chi phí lớn nhất và cũng làm câu trả lời loãng đi.
- Không ghi lại câu hỏi và câu trả lời. Không có nhật ký thì không cải thiện được, và không xử lý được khi người dùng phản ánh sai.
- Không có cơ chế nói không biết. Hệ thống bịa ra câu trả lời khi không tìm thấy tài liệu liên quan là vấn đề nghiêm trọng hơn việc trả lời thiếu.
Về dữ liệu: tài liệu nội bộ gửi qua dịch vụ mô hình bên ngoài là dữ liệu rời khỏi công ty. Kiểm hợp đồng và quy định nội bộ trước, và cân nhắc chạy mô hình trên máy chủ của mình nếu tài liệu nhạy cảm.
FAQ
pgvector có scale đến bao nhiêu vector?
Với HNSW index, pgvector chạy ổn tới 1-2M vector trên VPS 8GB RAM. Latency p95 vẫn dưới 300ms. Trên 5M, nên cân nhắc Qdrant/Milvus chuyên dụng. Mẹo: shard table theo tenant nếu multi-tenant - mỗi user query chỉ trong 100k chunk của họ.
Chunk size bao nhiêu là tối ưu?
Thường 256-512 token với overlap 50-100 token. Quá nhỏ (100): mất ngữ cảnh. Quá lớn (2000): retrieval kém chính xác. Với doc kỹ thuật code, chunk 512 token là sweet spot. Với prose văn xuôi, 256 token đủ. Test với eval set của bạn để tinh chỉnh.
Claude context dài 200k, có cần RAG không?
Có. 200k context = ~150 trang. Knowledge base thường lớn hơn nhiều (10000+ trang). RAG vẫn cần thiết để filter context relevant trước khi gửi LLM. Bonus: tốn ít token mỗi query (~3k thay vì 200k), giảm cost 60-70x. Tăng tốc độ response 3-5x.
Cách handle update document (sửa file đã ingest)?
Khi update file: DELETE FROM documents WHERE source='abc' (cascade xoá chunks), rồi ingest_file lại. Bonus: thêm cột content_hash MD5 trong documents, ingest chỉ re-embed khi hash thay đổi - tiết kiệm cost embedding. Cho file lớn (PDF 200 trang), chia thành chunks ổn định để diff-update chỉ chunks thay đổi.
Có thể dùng multi-modal (image + text) trong RAG?
Có. Embed image bằng CLIP hoặc voyage-multimodal-3, store vector cùng table chunks (thêm cột content_type). Query embedding text vào tìm cả text và image. Claude Sonnet/Opus 4 hỗ trợ vision input, paste image vào context để generate answer. Phù hợp Q&A trên product catalog có ảnh.
RAG có ổn cho tiếng Việt không?
Có. voyage-3 và text-embedding-3 hỗ trợ tiếng Việt tốt. Lưu ý: tokenizer mặc định Python (re.split) không tối ưu cho tiếng Việt, dùng pyvi hoặc underthesea để word-segment trước khi chunk. Claude Sonnet 4.7 sinh answer tiếng Việt natural. Test với corpus Wikipedia VN cho recall@5 trên 85%.