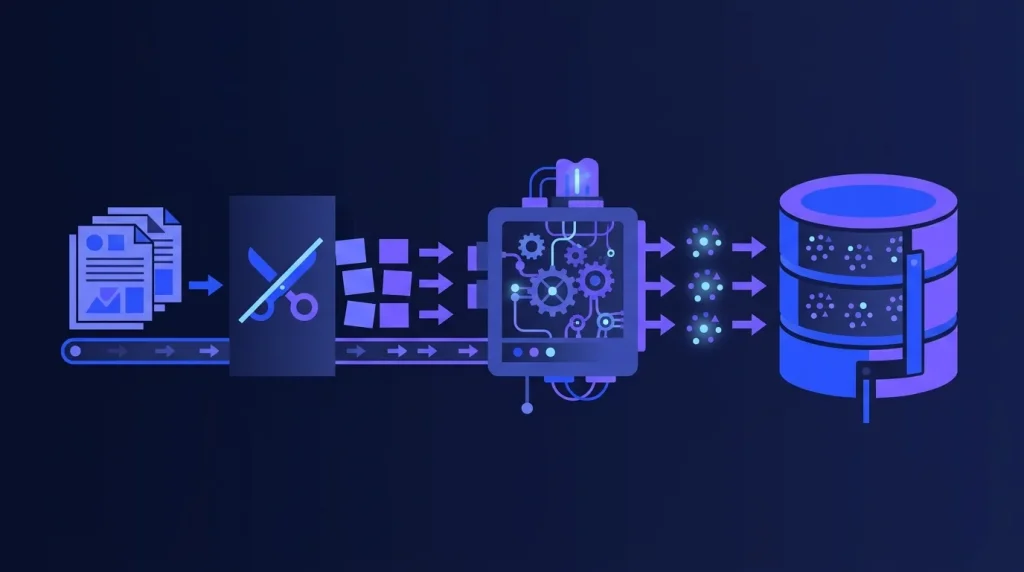
Trả lời nhanh: Bốn khâu với đặc thù khác nhau. Nạp và cắt tài liệu đọc ghi rất nhiều file, đây là khâu nặng ổ đĩa nhất và chỉ chạy khi cập nhật dữ liệu. Sinh vector gọi API nên chủ yếu là chờ mạng. Lưu vector vào database ghi liên tục. Truy vấn thì nhanh nếu chỉ mục nằm trong RAM và chậm hẳn khi phải đọc ổ. Vì vậy cấu hình nên ưu tiên RAM đủ giữ chỉ mục, và ổ NVMe cho khâu nạp dữ liệu cùng trường hợp dữ liệu vượt RAM.
Pipeline chạy mượt với năm trăm tài liệu. Đổ vào năm mươi nghìn tài liệu thì khâu nạp mất cả đêm và mỗi truy vấn mất vài giây.
- Khâu nạp và cắt tài liệu nặng ổ đĩa nhất nhưng chỉ chạy khi cập nhật.
- Khâu truy vấn nhanh khi chỉ mục nằm trong RAM.
- Sinh vector chủ yếu là chờ mạng, không tốn tài nguyên máy.
- Ưu tiên RAM cho chỉ mục, ổ NVMe cho khâu nạp và khi dữ liệu vượt RAM.
Bốn khâu và thứ chúng ngốn
| Khâu | Ngốn gì | Tần suất chạy |
|---|---|---|
| Nạp và cắt tài liệu | Ổ đĩa, CPU | Khi cập nhật dữ liệu |
| Sinh vector | Chờ mạng | Khi cập nhật dữ liệu |
| Lưu vào database | Ổ đĩa | Khi cập nhật dữ liệu |
| Truy vấn khi dùng | RAM, hoặc ổ đĩa nếu tràn RAM | Liên tục |
Điểm quan trọng ở cột cuối: ba khâu đầu chỉ chạy khi cập nhật, khâu cuối chạy suốt. Vì vậy tối ưu cho khâu cuối quan trọng hơn, nhưng ba khâu đầu quyết định bạn phải chờ bao lâu mỗi lần đổ dữ liệu mới.
Vì sao khâu nạp lại nặng ổ đến vậy
Nạp tài liệu là mở hàng nghìn file, đọc nội dung, cắt thành đoạn nhỏ, ghi kết quả trung gian ra đĩa. Một bộ tài liệu vài chục nghìn file nghĩa là vài trăm nghìn thao tác đọc ghi file nhỏ.
Đây là kiểu tải mà ổ NVMe bỏ xa ổ thường. Với bộ dữ liệu lớn, khác biệt có thể là chạy xong trong một giờ hay chạy suốt đêm.
Cấu hình theo lượng tài liệu
| Quy mô | RAM | Ổ |
|---|---|---|
| Dưới 5.000 đoạn | 4GB | NVMe 40GB |
| 5.000 tới 50.000 đoạn | 8GB | NVMe 80GB |
| Trên 100.000 đoạn | 16GB trở lên | NVMe 160GB trở lên |
Ba mẹo giảm tải
- Chỉ nạp lại phần thay đổi. Lưu dấu vân tay của từng tài liệu, tài liệu không đổi thì bỏ qua. Đây là cải thiện lớn nhất cho khâu cập nhật.
- Cắt đoạn hợp lý. Đoạn quá nhỏ làm số vector phình lên vô ích, đoạn quá lớn làm kết quả tìm kiếm kém chính xác.
- Lọc trước khi tìm vector. Giới hạn theo thời gian hoặc theo nhóm tài liệu giúp giảm mạnh lượng dữ liệu phải quét.
Bảng bốn khâu và tài nguyên chúng chiếm
| Khâu | Ngốn gì nhất | Chạy khi nào |
|---|---|---|
| Đọc và tách tài liệu | Ổ đĩa, đọc nhiều tệp | Lúc nạp dữ liệu |
| Sinh vector cho từng đoạn | Vi xử lý hoặc gọi dịch vụ ngoài | Lúc nạp dữ liệu |
| Ghi vector và dựng chỉ mục | Ổ đĩa, ghi rất nhiều | Lúc nạp dữ liệu, nặng nhất |
| Tìm kiếm khi có câu hỏi | Bộ nhớ nếu chỉ mục nằm gọn, ổ đĩa nếu không | Mỗi lượt người dùng hỏi |
Điểm hay bị hiểu nhầm: khâu nặng ổ đĩa nhất là lúc nạp dữ liệu, không phải lúc phục vụ. Nghĩa là máy có thể chạy êm hằng ngày rồi nghẽn hẳn vào ngày bạn nạp thêm một nghìn tài liệu.
Bảng cấu hình theo số đoạn văn bản
| Số đoạn văn bản | Bộ nhớ | Ổ đĩa | Ghi chú |
|---|---|---|---|
| Dưới 50.000 | 4 GB | NVMe 40 GB | Chỉ mục nằm gọn trong bộ nhớ |
| 50.000 tới 500.000 | 8 GB | NVMe 100 GB | Mức phổ biến cho tra cứu tài liệu nội bộ |
| Trên 500.000 | 16 GB trở lên | NVMe 200 GB trở lên | Tốc độ ổ bắt đầu quyết định |
Nạp theo lô để không nghẽn ổ đĩa
# 1. Nap theo lo, khong nap tat ca cung luc
#    Nap 500 tai lieu moi lan, nghi giua cac lo
#    Tranh lam nghen o dia va anh huong nguoi dung dang tra cuu

# 2. Nap vao gio thap diem, dat lich ban dem
#    0 2 * * * /opt/rag/nap-tai-lieu.sh >> /var/log/nap.log 2>&1

# 3. Chay lai thong ke sau khi nap lo lon, buoc hay bi quen
psql -c "ANALYZE;"

# Theo doi trong luc nap
watch -n5 'free -h; df -h /; uptime'
iostat -x 2 30
Hai việc quan trọng hơn cả cấu hình máy
- Đừng nạp lại toàn bộ mỗi lần cập nhật. Chỉ nạp phần tài liệu đã thay đổi. Rất nhiều hệ thống nạp lại từ đầu mỗi đêm một cách vô ích, và đó là nguyên nhân chính làm ổ đĩa quá tải.
- Chia đoạn cho hợp lý ngay từ đầu. Chia quá nhỏ làm số bản ghi phình lên gấp nhiều lần, kéo theo cả dung lượng lẫn thời gian tìm. Thử vài kích thước trên chính tài liệu của bạn rồi so chất lượng trước khi nạp toàn bộ.
Câu hỏi thường gặp
RAG pipeline cần bao nhiêu RAM?
Tuỳ số đoạn văn bản. Dưới 5.000 đoạn thì 4GB đủ, trên 100.000 đoạn nên 16GB để chỉ mục nằm trong bộ nhớ.
Khâu nào chậm nhất?
Khâu nạp và cắt tài liệu khi cập nhật dữ liệu lớn. Khâu truy vấn thì nhanh nếu chỉ mục nằm trong RAM.
Ổ NVMe giúp gì cho RAG?
Rút ngắn rõ rệt khâu nạp dữ liệu, và giúp khâu truy vấn khi dữ liệu đã vượt quá RAM nên phải đọc ổ.
Có cần GPU cho RAG không?
Không, nếu bạn gọi API để sinh vector và sinh câu trả lời. GPU chỉ cần khi tự chạy mô hình tại chỗ.