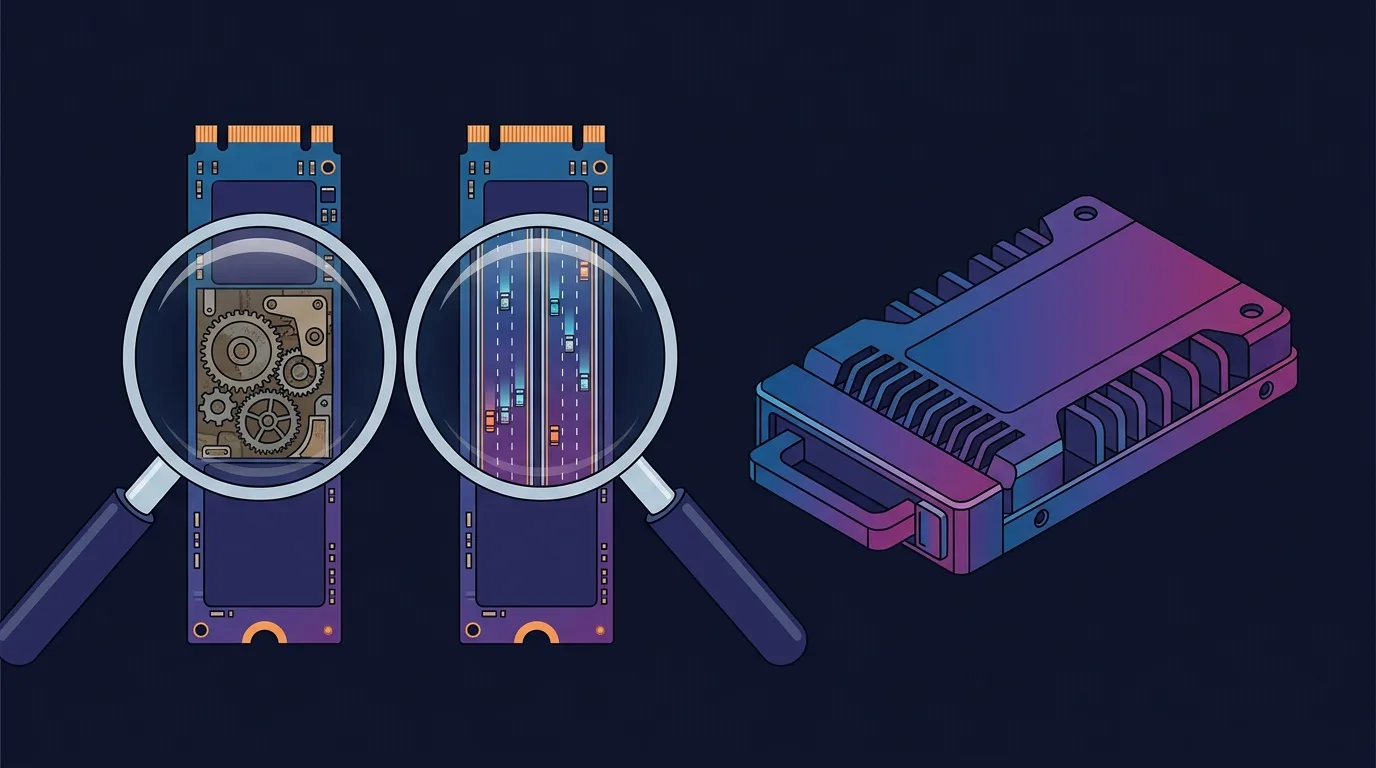

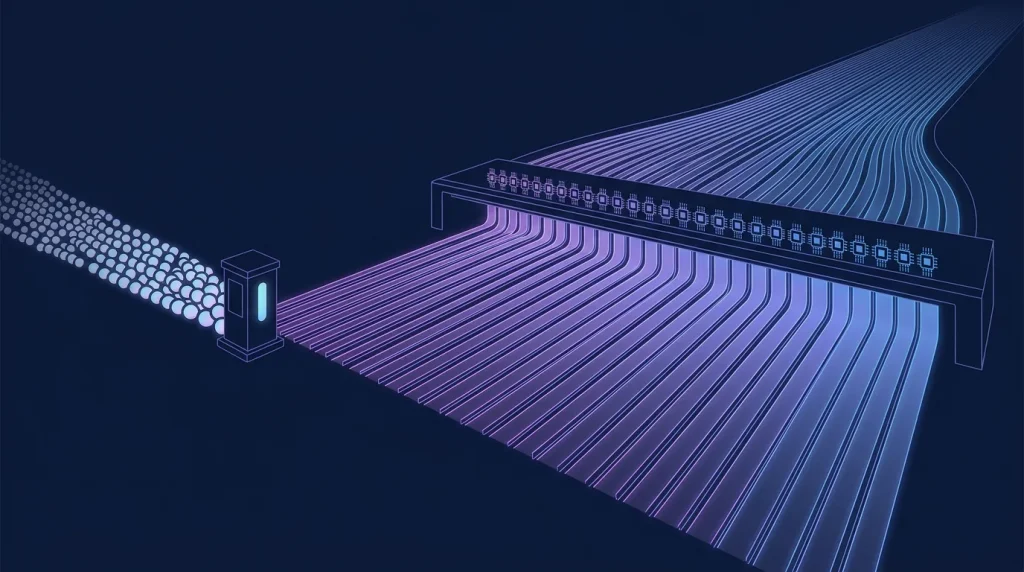
Trả lời nhanh: Khác biệt ăn sâu nhất giữa hai chuẩn không phải MB/s mà là hàng đợi lệnh: SATA/AHCI cho phép 1 hàng đợi × 32 lệnh đang chờ; NVMe cho phép 65.535 hàng đợi × 65.536 lệnh mỗi hàng. Với một người dùng chép một file, khác biệt nhỏ; với máy chủ nơi hàng trăm request cùng đòi đọc ghi, đó là khác biệt giữa quầy duy nhất 32 chỗ xếp hàng và cả siêu thị mở mọi quầy. Đây là lý do NVMe giữ latency phẳng khi tải đồng thời tăng, phẩm chất đáng tiền nhất của nó trên VPS.
Các bài trước đã nhắc 'queue depth' như một lời chú thích, bài này dành trọn cho nó, vì đây là khái niệm giải thích được hiện tượng ai vận hành cũng từng gặp: máy chạy lẻ tẻ thì nhanh, cứ đông việc là ì đồng loạt. Hiểu hàng đợi, bạn hiểu vì sao hai ổ 'cùng IOPS trên giấy' cư xử khác hẳn nhau lúc 21 giờ tối.
- Queue depth = số lệnh I/O được phép 'đang bay' cùng lúc, băng chuyền của ổ đĩa
- SATA: 1×32, di sản thiết kế cho ổ cơ chỉ phục vụ tuần tự một đầu đọc
- NVMe: 64K×64K + mỗi nhân CPU một hàng riêng, không tranh khóa, không chen lấn
- Hệ quả đo được: latency SATA phình khi QD tăng; NVMe phẳng, thấy rõ qua fio iodepth
Hàng đợi là gì và vì sao nó tồn tại
CPU không gửi từng lệnh đọc rồi khoanh tay chờ, nó xếp nhiều lệnh vào hàng đợi để ổ xử lý gối đầu: trong lúc lệnh 1 đang lấy dữ liệu, lệnh 2-3-4 đã sẵn sàng. Hàng đợi càng sâu, ổ càng được phép sắp xếp tối ưu và tận dụng độ song song bên trong (flash có hàng chục kênh chip đọc được cùng lúc). SATA thiết kế thời ổ cơ, một đầu đọc cơ khí thì 32 chỗ chờ là thừa; flash hiện đại với độ song song nội tại khổng lồ bị chuẩn cũ trói như cao tốc 16 làn phải đi qua trạm thu phí một cửa.
NVMe: mỗi nhân CPU một cửa riêng
NVMe không chỉ nâng số hàng đợi, nó đổi kiến trúc: mỗi nhân CPU tạo được cặp hàng đợi riêng nói thẳng với ổ, không qua khóa chung. Máy 12 nhân là 12 luồng I/O song song không tranh nhau, khớp hoàn hảo với hiện thực máy chủ: web server đa tiến trình, database nhiều connection, container chen vai. Cộng đường lệnh ngắn hơn (bớt lớp trung gian AHCI), mỗi lệnh NVMe tốn ít chu kỳ CPU hơn, ở IOPS cao, chính CPU overhead của AHCI cũng thành thứ đáng kể.
Nhìn thấy hàng đợi bằng fio - thí nghiệm 5 phút
# do cung mot o o cac do sau hang doi khac nhau:
for qd in 1 8 32 128; do
  fio --name=q$qd --filename=/tmp/t --size=1G --rw=randread --bs=4k
      --iodepth=$qd --runtime=15 --time_based 2>/dev/null | grep -E 'IOPS|clat.*avg'
done; rm /tmp/t
Đọc kết quả như đọc tính cách ổ: SATA, IOPS tăng đến QD 32 rồi kịch trần, latency bắt đầu phình theo QD (lệnh xếp hàng chờ chỗ); NVMe tử tế, IOPS leo tiếp qua QD 32/128, latency giữ phẳng đáng kinh ngạc. Đường cong đó chính là 'khả năng chịu đông khách' của máy, thứ không bảng giá nào in nhưng fio 5 phút lộ hết.
Áp vào đời vận hành: những cảnh hàng đợi quyết định
- Giờ vàng web bán hàng: trăm khách × chục query = QD thực tế vọt cao, NVMe phẳng lặng, SATA bắt đầu 'mỗi thứ chậm đi một tí' rồi cộng dồn thành trang ì.
- Nhiều dịch vụ chung máy (mô hình compose cả stack): app + database + Redis + backup đêm là các dòng I/O song song, kiến trúc mỗi-nhân-một-hàng của NVMe sinh ra cho đúng cảnh này.
- Nhiều agent AI song song (worktree + tmux): ba bốn npm ci/build cùng lúc, câu chuyện quen của cụm bài vibe code, và là tải QD cao điển hình mới của thời đại.
- RAID 10 nhân thêm: lệnh rải qua nhiều ổ NVMe = tổng hàng đợi lại nhân lên, lý do cấu hình U.2 RAID 10 cân được tải mà ổ đơn đã đuối.
Thí nghiệm cho thấy hàng đợi quyết định thế nào
apt install -y fio

# Cung mot o, chi doi do sau hang doi va so luong tien trinh
# 1. Mot yeu cau tai mot thoi diem: do tre thuan tuy
fio --name=q1 --ioengine=libaio --direct=1 --bs=4k --rw=randread \
    --iodepth=1 --numjobs=1 --size=1G --runtime=60 --time_based --group_reporting

# 2. Hang doi sau, mot tien trinh
fio --name=q32 --ioengine=libaio --direct=1 --bs=4k --rw=randread \
    --iodepth=32 --numjobs=1 --size=1G --runtime=60 --time_based --group_reporting

# 3. Hang doi sau, nhieu tien trinh: gan voi thuc te may chu nhat
fio --name=q32n4 --ioengine=libaio --direct=1 --bs=4k --rw=randread \
    --iodepth=32 --numjobs=4 --size=2G --runtime=60 --time_based --group_reporting

# So ba ket qua: o giao thuc cu thuong khong tang duoc nhieu tu buoc 1 sang 3,
# o giao thuc moi tang rat manh. Do la khac biet ve hang doi.
Những cảnh hàng đợi quyết định
| Tình huống | Hàng đợi có quan trọng không |
|---|---|
| Một người dùng, một truy vấn tại một thời điểm | Không, độ trễ đơn lẻ mới quan trọng |
| Trang web có vài chục khách đồng thời | Rất quan trọng |
| Máy chủ chạy nhiều dịch vụ cùng lúc | Rất quan trọng |
| Cơ sở dữ liệu có nhiều kết nối song song | Rất quan trọng |
| Sao lưu, truyền tệp lớn tuần tự | Không, băng thông mới quan trọng |
Đây là lý do một phép đo đơn giản với một tiến trình không nói lên được khác biệt thật. Máy chủ trong đời thật luôn có nhiều thứ đọc ghi cùng lúc, và đó là lúc hàng đợi sâu tạo khác biệt.
Cách áp vào quyết định thuê máy
- Hỏi rõ giao thức ổ đĩa, không dừng ở chữ ổ thể rắn.
- Yêu cầu dùng thử để tự đo bằng ba lệnh ở trên, và đo vào giờ cao điểm.
- Kiểm cả steal time, vì ổ nhanh mà máy chủ vật lý quá tải thì cũng không giữ được tốc độ.
- Với cơ sở dữ liệu và máy chủ nhiều dịch vụ, đây là khoản đáng trả thêm. Với kho lưu trữ tệp thì không.
Câu hỏi thường gặp
Queue depth bao nhiêu là 'đủ' cho web thường?
Không phải số để cấu hình mà là hành vi để hiểu: tải web tự sinh QD theo lượng khách. Việc của bạn là chọn ổ giữ latency phẳng ở QD cao, tức NVMe, thay vì đi chỉnh con số.
SSD SATA của tôi ghi 100K IOPS, sao vẫn ì lúc đông?
IOPS đỉnh đo ở điều kiện lý tưởng; lúc đông, trần 32 lệnh làm latency mỗi lệnh phình, IOPS tổng có thể vẫn ổn nhưng mỗi khách chờ lâu hơn. Latency dưới tải mới là số phản ánh cảm giác.
NCQ của SATA có phải cùng thứ này không?
Đúng, NCQ chính là cái hàng đợi 32 lệnh đó (Native Command Queuing). Nó là nâng cấp tốt của thời ổ cơ; chỉ là flash cần thứ lớn hơn nó hai bậc.
Ảo hóa có làm mất lợi thế hàng đợi NVMe không?
Ảo hóa tử tế (KVM + virtio hiện đại) giữ được phần lớn độ song song; ảo hóa cũ/cấu hình kém có thể bóp lại. Lại là fio trả lời: chạy bài QD trên chính VPS, đường cong nói thật thay nhà cung cấp.