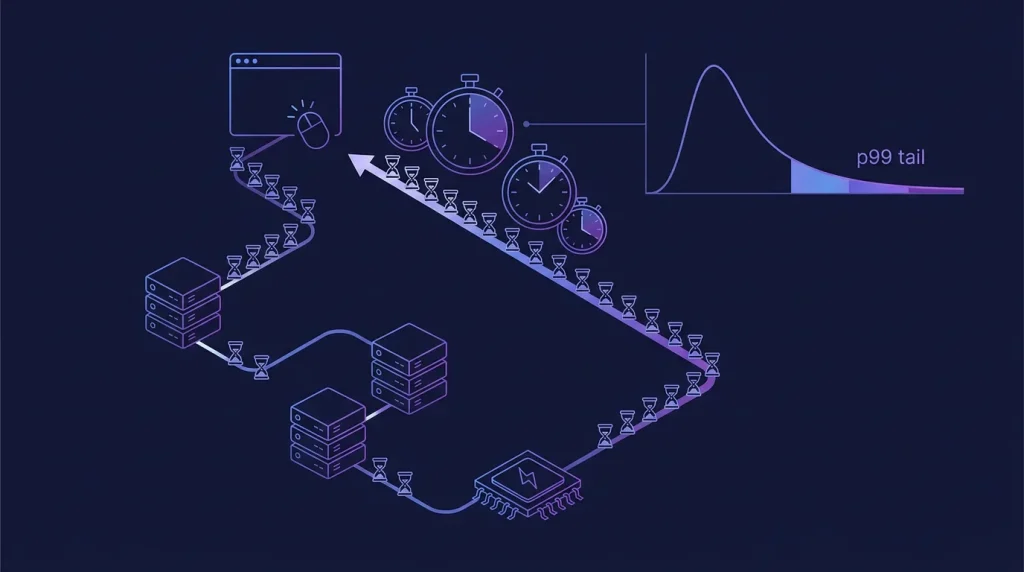
Trả lời nhanh: Latency là thời gian chờ một lệnh hoàn thành, với ổ đĩa tính bằng micro-giây (µs): NVMe enterprise ~50-100µs, SATA vài trăm µs, HDD 5-10ms (gấp trăm lần). Nghe đều 'nhanh', cho đến khi nhân lên: một trang web động = chuỗi hàng chục đến hàng trăm lượt chờ ổ nối tiếp (query → index → row → fsync log...), nên 100µs so với 500µs không phải chênh 400µs, mà là chênh vài chục mili-giây TTFB, đủ đổi hạng cảm giác trang. Và con số cần nhìn không phải trung bình mà là p99, độ trễ của những lượt tệ nhất, thứ khách hàng thật sự cảm nhận.
IOPS trả lời 'làm được bao nhiêu việc mỗi giây'; latency trả lời 'mỗi việc chờ bao lâu', và với trải nghiệm người dùng, câu thứ hai sát hơn. Bài này lần theo một lượt bấm chuột từ trình duyệt xuống tận chip flash rồi ngược lên, chỉ ra các điểm khuếch đại, nơi vài micro-giây của ổ phình thành mili-giây của trang, và dạy đo đúng chỉ số p99 mà các bản đo hời hợt bỏ qua.
- Thang latency: RAM ~100ns · NVMe ~50-100µs · SATA ~300-500µs · HDD 5-10ms · khứ hồi mạng VN 5-20ms
- Chuỗi khuếch đại: một trang = N lượt chờ ổ NỐI TIẾP, latency nhân N lần vào TTFB
- Trung bình nói dối: p99 (1% lượt chậm nhất) mới là thứ khách gặp vào giờ đông
- fsync là latency trần trụi nhất: mỗi commit database chờ đúng một vòng xuống ổ
Thang đo - đặt mọi con số cạnh nhau
Để trực giác đúng, phóng đại lên thang giây: nếu đọc RAM là 1 giây, thì NVMe là ~10 phút, SATA là ~1 tiếng, HDD là cả tuần, và một vòng mạng đến khách Việt là ~1 tháng. Hai bài học từ thang này: (1) mọi tầng cache tồn tại để tránh phải 'đi cả tuần', và khi cache trượt, khoảng cách NVMe/HDD là khoảng cách 10 phút với 7 ngày; (2) ổ nhanh không thay được máy đặt gần khách, mạng vẫn là chặng dài nhất, hai thứ giải hai bài khác nhau như bài VPS-Việt-Nam đã tách bạch.
Chuỗi khuếch đại: từ một cú bấm đến N lượt chờ ổ
Khách mở trang sản phẩm, phía sau: query lấy sản phẩm (đọc index 3-4 node + row), query liên quan (lại index + rows), session (đọc), ghi log (ghi + có thể fsync), template đọc partial từ ổ nếu chưa cache... Cộng thô: 30-150 lượt chạm ổ, phần lớn nối tiếp (lượt sau cần kết quả lượt trước). Phép nhân thẳng: 80 lượt × 80µs (NVMe) ≈ 6ms phần ổ; 80 × 400µs (SATA) ≈ 32ms; 80 × 7ms (HDD) ≈ nửa giây, chưa tính tầng nào khác. Đó là cơ chế biến 'chênh vài trăm micro-giây' thành 'trang này nhanh, trang kia ì' mà người không đo đạc chỉ biết đổ cho code.
p99: sự thật nằm ở phần đuôi
Latency trung bình 100µs nghe đẹp, nhưng nếu 1% lượt mất 20ms (ổ bận, GC controller, hàng xóm chen), thì cứ ~100 lượt chạm ổ lại dính một cú 20ms; trang cần 80 lượt gần như chắc chắn dính. Vì thế nghề đo hiệu năng thờ chỉ số p99/p99.9, '99% lượt nhanh hơn X'. Đo bằng fio:
fio --name=lat --filename=/tmp/t --size=1G --rw=randread --bs=4k --iodepth=1
    --runtime=60 --time_based --percentile_list=50:99:99.9 | grep -E 'clat percentiles|50th|99th'
rm /tmp/t
Ổ enterprise tử tế: p99 vẫn dưới vài trăm µs, phẳng qua các khung giờ. Ổ oversell/gia dụng: trung bình đẹp mà p99 nhảy sang mili-giây theo giờ đông, chính là 'thi thoảng khựng' mà khách phàn nàn còn dashboard trung bình thì chối.
Ba điểm chạm latency đáng tối ưu nhất
- fsync của database: mỗi commit = một vòng chờ ổ trần trụi không cache nào đỡ. NVMe + PLP đưa nó về ~vài chục µs, lý do web bán hàng ghi đơn mượt trên nền này (và lý do bài enterprise gọi PLP là ranh giới).
- Cache miss dồn đợt: sau deploy/restart, cache lạnh, hàng loạt lượt chạm ổ cùng lúc: p99 của ổ quyết định site 'ấm lại' trong giây hay trong phút.
- Swap và vạn-file: hai kịch bản 4K thuần đã có bài riêng (swap, npm), cùng một gốc: latency mỗi trang/file nhân số lượng khổng lồ.
Chuỗi khuếch đại: một cú bấm thành bao nhiêu lượt chờ ổ
| Loại trang | Số lượt đọc ổ điển hình cho một lượt xem | Ghi chú |
|---|---|---|
| Trang tĩnh đã nằm trong bộ nhớ đệm | 0 | Không chạm ổ |
| Trang tin đơn giản | 5 tới 20 | Vài truy vấn, vài tệp |
| Trang thương mại điện tử có danh mục và giỏ hàng | 50 tới 200 | Nhiều truy vấn, nhiều lần đọc |
| Trang quản trị có báo cáo | hàng trăm | Truy vấn gộp nhóm đọc rất nhiều |
Đây là lý do độ trễ ổ đĩa quan trọng hơn vẻ ngoài của nó: chênh lệch vài chục micro giây cho một lần đọc, nhân với hàng trăm lần đọc, thành chênh lệch hàng chục mili giây mà người dùng cảm nhận được.
Đo độ trễ thật, và nhìn phần đuôi
apt install -y fio

# Do do tre voi mot yeu cau tai mot thoi diem
fio --name=dotre --ioengine=libaio --direct=1 --bs=4k --rw=randread \
    --iodepth=1 --numjobs=1 --size=1G --runtime=120 --time_based \
    --group_reporting --percentile_list=50:95:99:99.9

# Doc ket qua: KHONG chi nhin trung binh
#   clat percentile 50 la truong hop dien hinh
#   clat percentile 99 la truong hop te, va day moi la thu nguoi dung nho
#   clat percentile 99.9 cho biet phan duoi te den dau

# Do trong luc co tai that, khong phai luc may ranh
iostat -x 2 30   # cot await la do tre trung binh moi yeu cau
Nguyên tắc đọc số: trung bình đẹp mà phần trăm thứ 99 rất xấu nghĩa là cứ 100 người dùng thì có một người gặp trang rất chậm. Với trang có nghìn lượt mỗi ngày, đó là hàng chục người mỗi ngày có trải nghiệm tệ.
Ba điểm chạm đáng tối ưu nhất
- Giảm số lượt đọc trước khi tăng tốc mỗi lượt đọc. Bỏ truy vấn thừa và thêm chỉ mục đúng cắt được phần lớn chuỗi khuếch đại, và không tốn tiền.
- Đưa dữ liệu nóng vào bộ nhớ. Đọc từ bộ nhớ nhanh hơn đọc từ ổ nhiều bậc, kể cả ổ nhanh nhất.
- Chỉ khi hai việc trên đã làm mới đổi ổ. Lúc đó khác biệt về độ trễ mới thể hiện hết giá trị.
Thứ tự này quan trọng: đổi ổ nhanh cho một ứng dụng đang đọc thừa gấp mười lần cần thiết là mua tốc độ để bù cho lãng phí. Xem VPS NVMe.
Câu hỏi thường gặp
Latency và ping có phải một thứ không?
Cùng khái niệm 'thời gian chờ khứ hồi', khác tầng: ping đo mạng, bài này đo ổ. Chúng cộng vào nhau trong TTFB, và mỗi tầng tối ưu theo cách riêng của nó.
iodepth=1 trong lệnh đo có ý nghĩa gì?
Đo latency 'thuần', từng lệnh một, không xếp hàng: con số phản ánh bản chất ổ. Tăng iodepth đo thêm hành vi dưới tải (bài queue depth), hai phép đo bổ nhau.
Vì sao latency của tôi cao bất thường dù là NVMe?
Nghi phạm quen: storage mạng đội lốt (cộng độ trễ đường mạng, vài ms là dấu vân tay), máy hàng xóm chen I/O, hoặc chính máy bạn đang swap nặng. Đo lúc máy nhàn để tách bạch, rồi lần theo bài 5-bẫy-thuê-VPS.
App của tôi làm gì được với latency ngoài đổi ổ?
Giảm số lượt chờ nối tiếp: index đúng (ít node phải đọc), gộp query (bớt khứ hồi), cache tầng trên, connection pool ấm sẵn. Kiến trúc giảm N, ổ giảm mỗi-lượt, nhân đôi hiệu quả khi làm cả hai.