
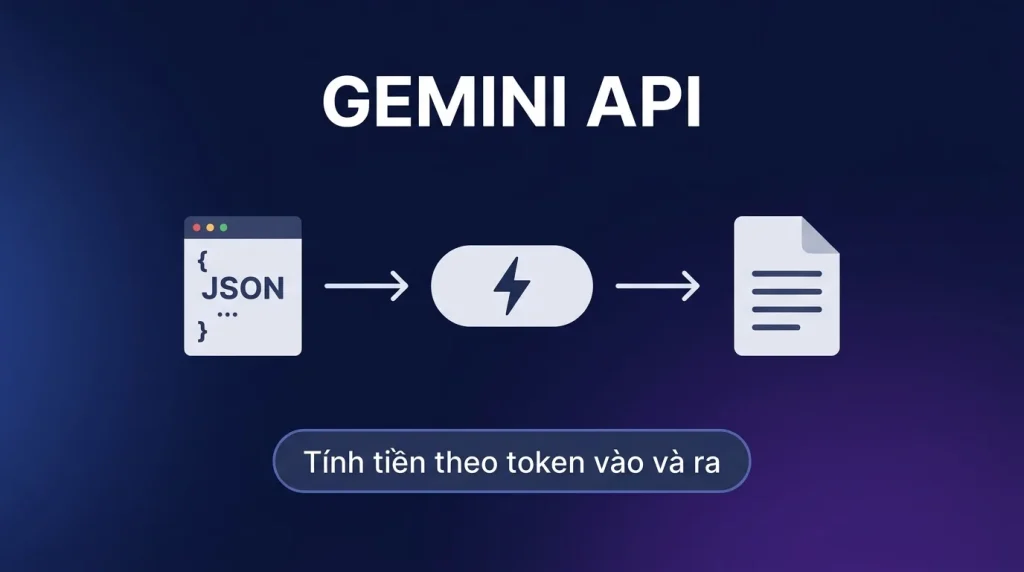
Trả lời nhanh: Gemini API là cách gọi model Gemini bằng máy: bạn gửi một request HTTP kèm API key và nội dung, nhận về câu trả lời dạng JSON. Ba thứ cần nắm để không lạc: chọn model (Flash cho việc lặp lại, Pro cho việc khó), quota (bậc free giới hạn theo phút/ngày, bậc trả phí rộng hơn nhiều) và cách tính tiền (theo token vào và token ra, không phải theo số câu hỏi).
Có key rồi thì câu hỏi tiếp theo luôn là: gọi thế nào, chọn model nào, và cuối tháng mất bao nhiêu tiền. Tài liệu chính thức trả lời đủ cả nhưng rải rác và bằng tiếng Anh, còn bài hướng dẫn tiếng Việt trên mạng thì phần lớn chép lại từ thế hệ model đã nghỉ hưu. Bài này gom đúng phần bạn cần để chạy được việc thật, kèm những chỗ dễ vấp mà chỉ khi bị lỗi mới biết.
- Một request Gemini gồm: model + contents + (tùy chọn) systemInstruction và generationConfig
- Flash: rẻ, nhanh, quota rộng, mặc định nên dùng; Pro: đắt và chậm hơn, để dành việc suy luận nặng
- Tính tiền theo token: cả phần bạn gửi lên lẫn phần model trả về, ước lượng 1 token ≈ 0,75 từ tiếng Anh
- Lỗi hay gặp: 429 vượt quota, 400 sai định dạng contents, 403 key sai hoặc chưa bật API
- Cần trả lời chảy dần như ChatGPT thì dùng streamGenerateContent, đừng chờ trọn câu
Hình dạng một request: đơn giản hơn bạn tưởng
Bỏ hết thư viện đi, bản chất Gemini API chỉ là một lời gọi HTTP POST tới địa chỉ có tên model, kèm key ở query hoặc header. Thân request tối thiểu chỉ cần mảng contents:
POST /v1beta/models/<ten-model>:generateContent?key=API_KEY
{
  "systemInstruction": {"parts":[{"text":"Ban la tro ly tom tat, tra loi tieng Viet, toi da 3 cau."}]},
  "contents": [{"role":"user","parts":[{"text":"Tom tat doan van sau: ..."}]}],
  "generationConfig": {"temperature": 0.2, "maxOutputTokens": 512}
}
Ba khối đáng nhớ: systemInstruction đặt vai và ràng buộc cố định (đừng nhồi phần này vào từng câu hỏi), contents là hội thoại, muốn model nhớ ngữ cảnh thì gửi lại cả các lượt trước với role user/model xen kẽ, vì API không tự lưu lịch sử giúp bạn; generationConfig chỉnh nhiệt độ và độ dài. Trong Python, thư viện chính thức google-genai gói gọn lại còn vài dòng, nhưng biết hình dạng thô giúp bạn gỡ lỗi nhanh gấp bội khi gọi từ n8n hay từ ngôn ngữ không có SDK.
Chọn model: Flash trước, Pro sau, và luôn kiểm tra tên
Gemini chia theo hai hướng chính: dòng Flash tối ưu tốc độ và giá, dòng Pro tối ưu năng lực suy luận. Kinh nghiệm dùng thật: khoảng 80% việc doanh nghiệp hay làm, tóm tắt, phân loại email, trích xuất trường từ hóa đơn, viết nháp trả lời khách, Flash làm tốt với giá rẻ hơn hẳn và độ trễ thấp hơn nhiều lần. Chỉ nâng lên Pro khi việc cần đọc tài liệu rất dài, suy luận nhiều bước hoặc sinh code phức tạp, và chỉ sau khi bạn đã đo thấy Flash sai thật.
Một thói quen bắt buộc: lấy tên model từ tài liệu hoặc từ endpoint liệt kê model, đừng chép trong bài viết cũ. Tên như gemini-1.5-* đã lỗi thời, mỗi thế hệ mới lại đổi chuỗi định danh, và gọi sai tên trả về lỗi 404 khiến nhiều người tưởng key hỏng. Trong code nên để tên model thành biến môi trường thay vì viết cứng, sau này đổi model chỉ sửa một dòng cấu hình, không phải sửa code và deploy lại. Nếu bạn đang phân vân giữa các thế hệ Pro, bài Gemini Pro vs Ultra cho coding đã so sánh sẵn ở góc lập trình.
Quota và lỗi 429: chuyện xảy ra với mọi người
Bậc miễn phí giới hạn theo ba trục: số request mỗi phút, số request mỗi ngày, và tổng token mỗi phút, mỗi model một mức, dòng Flash luôn rộng hơn. Khi vượt, API trả 429 RESOURCE_EXHAUSTED. Đây không phải lỗi của bạn, mà là hàng rào, và cách xử lý chuyên nghiệp gồm ba lớp:
Thử lại có lùi dần (exponential backoff): gặp 429 thì chờ 1 giây, rồi 2, rồi 4, đa số thư viện chính thức làm sẵn, nhưng khi gọi thô từ n8n hay bash bạn phải tự thêm. Gom việc: thay vì 100 request mỗi request một dòng, gộp 20 dòng vào một prompt và yêu cầu trả JSON mảng, vừa nhanh vừa rẻ vừa ít chạm trần. Hàng đợi: việc lớn thì đẩy qua hàng đợi chạy nền với tốc độ có kiểm soát thay vì bắn hết một lượt, đúng mô hình mà workflow trên VPS làm tốt còn máy cá nhân thì không.
Hai lỗi anh em thường gặp: 400 INVALID_ARGUMENT gần như luôn do sai cấu trúc contents (quên mảng parts, hoặc gửi role lạ); 403 là key sai, key bị xóa, hoặc API chưa được bật trong project Cloud tương ứng.
Tính tiền theo token: ước lượng trước khi hết tiền
Google tính tiền theo token vào (prompt của bạn, gồm cả system instruction và lịch sử hội thoại gửi kèm) và token ra (câu trả lời), đơn giá tính trên mỗi triệu token và luôn khác nhau giữa hai chiều, chiều ra đắt hơn. Quy đổi thô để ước lượng: 1 token ≈ 0,75 từ tiếng Anh; tiếng Việt có dấu tốn token hơn tiếng Anh khoảng 1,5-2 lần cho cùng nội dung, nên đừng lấy con số tiếng Anh áp thẳng cho nội dung Việt.
Ba đòn giảm tiền hiệu quả nhất, xếp theo mức độ ăn tiền: đừng gửi cả lịch sử hội thoại nếu không cần (chi phí phình theo từng lượt vì bạn trả tiền lại cho toàn bộ ngữ cảnh mỗi lần gọi, cắt còn 5 lượt gần nhất là đủ cho hầu hết chatbot); đặt maxOutputTokens để model không viết văn dài lê thê khi bạn chỉ cần một nhãn phân loại; chọn đúng model, hạ từ Pro xuống Flash cho việc đơn giản thường tiết kiệm nhiều lần hơn mọi tối ưu prompt cộng lại. Đọc tiếp phần so sánh chi phí giữa các nhà cung cấp ở bài so sánh giá AI API.
Streaming, JSON có cấu trúc và những thứ dùng nhiều nhất
Streaming: đổi generateContent thành streamGenerateContent để nhận từng mẩu trả lời, bắt buộc nếu bạn làm giao diện chat, vì chờ 8 giây rồi hiện cả đoạn khiến người dùng tưởng treo. JSON có cấu trúc: khai báo responseMimeType: application/json kèm schema mong muốn, model sẽ trả đúng khuôn để code parse thẳng, thứ vũ khí quan trọng nhất khi làm trích xuất dữ liệu, thay cho việc dùng biểu thức chính quy cắt gọt văn bản. Đa phương thức: gửi kèm ảnh hoặc PDF ngay trong parts để hỏi về nội dung file, rất hợp bài toán đọc hóa đơn, chứng từ, ảnh chụp màn hình lỗi của khách. Đếm token trước: endpoint countTokens cho biết prompt nặng bao nhiêu trước khi gửi, hữu ích để chặn trường hợp người dùng dán cả cuốn sách vào ô nhập.
Kiểm khóa và hạn mức trước khi chạy thật
# 1. Goi thu mot lan, xac nhan khoa hoat dong
curl -s "https://generativelanguage.googleapis.com/v1beta/models?key=$GEMINI_API_KEY" | head -c 500

# 2. Doc so token that su da dung, nam trong phan phan hoi
#    Truong usageMetadata cho biet token vao, token ra va tong

# 3. Xu ly loi vuot han muc: cho va thu lai theo cap so nhan
#    Lan 1 cho 1 giay, lan 2 cho 2 giay, lan 3 cho 4 giay, toi da 5 lan

# 4. Ghi lai moi lan bi tu choi vao nhat ky
#    Con so nay cho biet ban co can nang muc su dung khong
| Mã lỗi | Nghĩa | Cách xử |
|---|---|---|
| 400 | Yêu cầu sai định dạng, hoặc tên model sai | Kiểm tên model trong danh sách trả về ở lệnh một |
| 401 hoặc 403 | Khóa sai, hết hiệu lực, hoặc chưa bật dịch vụ | Tạo khóa mới, kiểm dịch vụ đã bật trong dự án |
| 429 | Vượt hạn mức tần suất | Chờ và thử lại giãn dần; đây là lỗi thường gặp nhất ở bậc miễn phí |
| 500 hoặc 503 | Phía dịch vụ đang lỗi | Thử lại, và có mô hình dự phòng |
| Trả lời rỗng | Nội dung bị bộ lọc chặn | Kiểm trường lý do kết thúc trong phản hồi |
Bậc miễn phí: hai cái giá cần biết
- Hạn mức tần suất thấp, nên không dùng được cho sản phẩm có người dùng thật. Hợp để học và thử nghiệm.
- Điều khoản về dữ liệu ở bậc miễn phí khác bậc trả phí. Đọc kỹ trước khi gửi dữ liệu khách hàng hoặc mã nguồn dự án qua đó. Đây là điểm quan trọng hơn cả hạn mức.
- Kết luận thực dụng: dùng bậc miễn phí để dựng và thử, chuyển sang bậc trả phí trước khi có người dùng thật hoặc trước khi đưa dữ liệu thật vào.
Ước chi phí trước khi chạy
- Quy tắc ước nhanh cho tiếng Việt: lấy số ký tự chia khoảng 2,5 để ra số token, thay vì chia 4 như tiếng Anh.
- Token đầu ra thường đắt hơn token đầu vào, nên chặn độ dài trả lời là cách tiết kiệm rẻ nhất.
- Với hội thoại nhiều lượt, lịch sử là đầu vào lặp lại. Cắt bớt lịch sử và giữ một bản tóm tắt ngắn.
- Đặt hạn mức chi tiêu trong bảng điều khiển trước khi cho quy trình tự động chạy, không phải sau khi nhận hóa đơn.
Câu hỏi thường gặp
Gemini API và Vertex AI khác nhau ra sao, nên chọn cái nào?
Cùng model, khác cửa vào: Gemini API dùng API key, đăng ký trong 30 giây, hợp cá nhân và đội nhỏ. Vertex AI đi qua hạ tầng Google Cloud với xác thực service account, phân quyền IAM, chọn vùng đặt dữ liệu và hợp đồng doanh nghiệp, chọn khi công ty đã dùng Google Cloud hoặc cần ràng buộc tuân thủ.
Gọi Gemini API từ Việt Nam có bị chặn không?
Không bị chặn, độ trễ tới máy chủ Google thường chỉ vài trăm mili giây và không phải vấn đề với ứng dụng thông thường. Điều đáng lưu ý nằm ở chiều ngược lại: nếu ứng dụng của bạn phục vụ khách trong nước, đặt backend tại Việt Nam sẽ giảm độ trễ cho phần lớn quãng đường.
Có cần thư viện chính thức không hay curl là đủ?
Việc nhỏ và trong n8n thì gọi HTTP thô hoàn toàn đủ. Viết ứng dụng thật nên dùng SDK chính thức vì nó lo sẵn thử lại, streaming, đếm token và cập nhật tên model. Cái giá phải trả là bạn phụ thuộc phiên bản thư viện, nên hãy ghim phiên bản trong file requirements.
Làm sao biết mình đang tiêu bao nhiêu tiền?
Bậc trả phí xem trong Google Cloud Billing của project chứa key, nên đặt ngưỡng cảnh báo qua email ngay khi bật thanh toán. Ngoài ra hãy tự ghi log số token mỗi lần gọi trong ứng dụng, con số theo từng tính năng cho bạn biết chỗ nào đang ngốn tiền, thứ hóa đơn tổng không nói được.